Vai al contenuto principale

#sql

sqlsimtools: il tool open source Microsoft che sostituisce ostress.exe per il load testing di SQL Server e Azure SQL

Per anni, chi doveva generare carico su un’istanza Server per un test di aveva un solo riferimento informale: ostress.exe, il tool s

Altro...

Per anni, chi doveva generare carico su un’istanza Server per un test di aveva un solo riferimento informale: ostress.exe, il tool scritto dal supporto Microsoft (Keith Elmore e Robert Dorr) mai distribuito ufficialmente ma passato di mano in mano tra DBA e sviluppatori .NET. Il problema è che ostress si appoggia a SQL Server Native Client, un componente che Microsoft non distribuisce più a partire da SQL Server 2022, e che su non ha mai avuto cittadinanza. Microsoft ha ora rilasciato il suo sostituto ufficiale, open source: sqlsimtools.

Cos’è sqlsimtoolssqlsimtools (github.com/microsoft/sqlsimtools, licenza MIT) è in realtà una suite di tre strumenti pensati per generare, eseguire, confrontare e replayare carichi di lavoro su SQL Server e Azure SQL in modo ripetibile:

sqlsim: il motore nativo a riga di comando, scritto in C++ sopra ODBC Driver 18. Gira su (x64 e ARM64) e su Linux x64 ( 24.04 e 26.04).

sqlpysim: la versione Python, basata sul driver mssql-python di Microsoft. Nei benchmark pubblicati raggiunge circa un decimo del throughput di sqlsim con 50 thread concorrenti, quindi va vista più come strumento di prototipazione e scripting che come generatore di carico ad alte prestazioni.

sqlsim Studio: un’applicazione locale, servita nel , per configurare visivamente un workload, eseguirlo, monitorarlo in tempo reale, confrontarlo con un run precedente e fare il replay. Al momento gira solo su Windows x64 in public preview; le altre piattaforme sono in anteprima privata su invito.

I target supportati coprono l’intero spettro Microsoft lato dati relazionali: SQL Server 2019, 2022 e 2025 on-premise, Azure SQL Database, Azure SQL Managed Instance e SQL database in Microsoft Fabric. L’autenticazione copre sia le credenziali SQL classiche sia Microsoft Entra ID, con supporto per access token, managed identity e service principal: un dettaglio non secondario per chi deve lanciare questi test da una pipeline CI/CD senza stoccare password in chiaro.

Primo avvioI pacchetti si scaricano dalla pagina delle release del repository. Su Windows, dato che gli eseguibili non sono firmati digitalmente, Microsoft raccomanda di sbloccare l’archivio prima di estrarlo, per evitare che SmartScreen blocchi silenziosamente i binari:

Unblock-File .\sqlsimtools--win-x64.zipAvviare sqlsim Studio è immediato: si estrae l’archivio e si lancia l’eseguibile, che apre l’interfaccia nel browser predefinito.

.\sqlsimstudio\sqlsimstudio.exeIl motore nativo si invoca invece da riga di comando, con una sintassi che richiama volutamente quella storica di sqlcmd/osql: -S per il server, -E per l’autenticazione integrata, -Q per la query. Un esempio tipico, contro il database di esempio AdventureWorksLT, con due thread concorrenti e una singola iterazione:

sqlsim.exe -S localhost -d AdventureWorksLT -E -Q "SELECT TOP (5) Name, ListPrice FROM SalesLT.Product ORDER BY ListPrice DESC"
-n 2 -r 1L’equivalente in sqlpysim richiede prima l’installazione delle dipendenze Python, poi usa gli stessi flag principali (con l’aggiunta di -C per accettare il certificato del server in connessioni cifrate non attendibili):

python -m pip install -r .\sqlpysim\requirements.txt
python .\sqlpysim\sqlpysim.py -S localhost -d AdventureWorksLT -E -C -Q "SELECT TOP (5) Name, ListPrice FROM SalesLT.Product ORDER BY ListPrice DESC"
-n 2 -r 1Entrambi i comandi stampano un riepilogo con driver utilizzato, numero di thread, iterazioni, risultati della query e un conteggio di esecuzioni riuscite/fallite: output pensato per essere incollato così com’è in un ticket o in un report di performance, oppure esportato in JSON per l’elaborazione automatica.

Workload misti e automazioneOltre alla singola query da riga di comando, sqlsimtools permette di descrivere workload misti in formato JSON, eseguire replay di carichi registrati in precedenza ed esportare i risultati in JSON per confronti automatizzati prima/dopo una modifica (un indice aggiunto, una riscrittura di query, un upgrade di versione). Per il riferimento completo dei flag e dello schema JSON, il progetto rimanda alla documentazione dedicata di ciascun componente (sqlsim/sqlsim.md e sqlpysim/sqlpysim.md nel repository), non ancora linkata direttamente dalla pagina principale.

L’integrazione con GitHub CopilotUn aspetto che distingue sqlsimtools da un classico tool da riga di comando è l’integrazione nativa con gli agenti AI da sviluppo. Il repository pubblica skill installabili per GitHub Copilot (e, secondo la documentazione, anche per Claude Code, Codex e Cursor):

copilot plugin marketplace add microsoft/sqlsimtools
copilot plugin install sqlsim@sqlsimtools
copilot plugin install sqlpysim@sqlsimtoolsUna volta installata, in VS Code è disponibile l’agente sqlsimtools Workload Builder: si apre la chat di Copilot, si descrive l’esperimento in linguaggio naturale (ad esempio “confronta questa query con e senza indice su AdventureWorksLT”) e l’agente costruisce i comandi di baseline e candidato, chiedendo conferma prima di eseguire qualunque cosa contro un target reale. Vale la pena notare che le skill forniscono solo la guida: l’eseguibile sqlsim o l’ambiente Python vanno comunque installati separatamente.

sqlsimtools contro ostress.exe: cosa cambia davveroAspettoostress.exesqlsimtoolsPiattaformaSolo WindowsWindows e LinuxDriverSQL Server Native Client (non più distribuito da SQL Server 2022)ODBC Driver 18 (sqlsim) o mssql-python (sqlpysim)Definizione workloadOpzioni da riga di comandoJSON, anche per scenari mistiConfronto risultatiManualeConfronto baseline/candidato ed export JSON integratiTargetSQL Server on-premiseSQL Server 2019/2022/2025, Azure SQL DB, Azure SQL MI, FabricStatoNon ufficiale, non più aggiornatoPublic preview, licenza MITUn avviso importante prima di adottarlo in produzione: sqlsimtools non è un prodotto Microsoft ufficiale e non è coperto da supporto commerciale Microsoft. Bug e richieste di funzionalità vanno segnalati su GitHub Issues e Discussions del repository, come per qualunque progetto open source gestito dalla community.

Prima di lanciare un test di carico: qualche buona praticaIndipendentemente dallo strumento usato, un test di workload ripetibile e utile richiede disciplina a monte: definire in anticipo query mix, dataset, concorrenza e durata attesa; usare sempre un database di non produzione con credenziali dedicate, verificando il target prima di ogni esecuzione; eseguire prima la baseline invariata, poi applicare una singola modifica alla volta e ripetere lo stesso run, conservando anche gli esiti dei run falliti; registrare versione dello schema, del tool e del driver insieme alla definizione del workload, così da poter riprodurre esattamente lo stesso test mesi dopo. Sono gli stessi principi che si applicavano con ostress, ma che il formato JSON e l’export dei risultati di sqlsimtools rendono molto più facili da automatizzare in una pipeline.

Conclusionesqlsimtools colma un vuoto che l’ecosistema SQL Server si portava dietro da anni: un tool di load testing moderno, open source, multipiattaforma, che non dipende da un driver ormai ritirato e che parla la stessa lingua JSON degli strumenti di automazione contemporanei. È ancora in preview, quindi non va considerato “pronto per la produzione” senza le dovute verifiche, ma per chi oggi usa ancora ostress.exe o si affida a script fatti in casa per simulare carico su Azure SQL, è il momento di iniziare a valutarlo.

Fonte: Microsoft Tech Community – Introducing sqlsimtools. Repository ufficiale: github.com/microsoft/sqlsimtools. Approfondimento: IT-Connect.
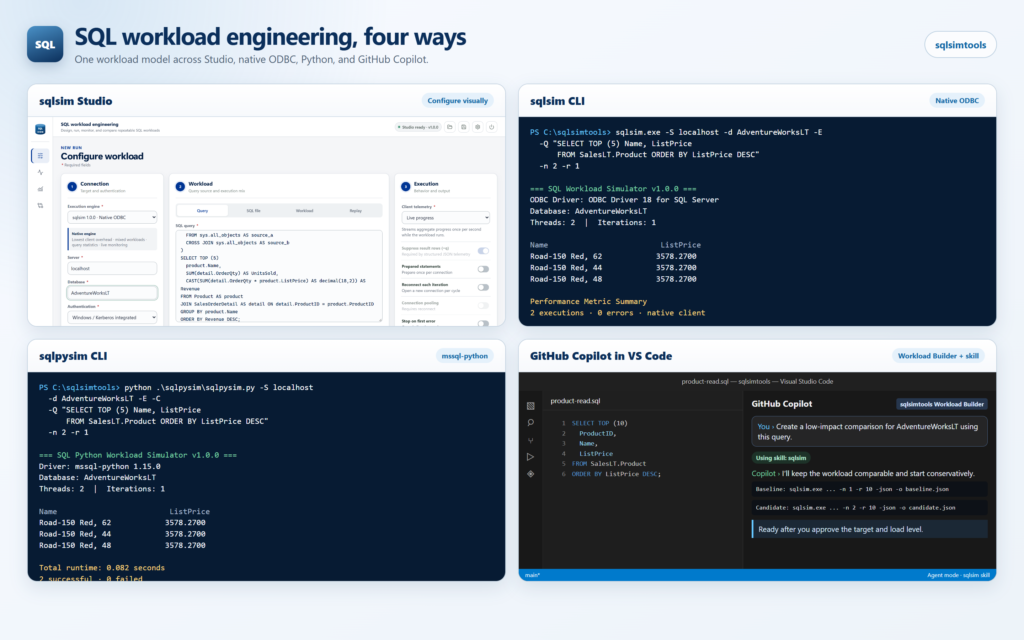
I quattro modi per usare sqlsimtools: Studio, CLI nativa sqlsim, CLI Python sqlpysim e GitHub Copilot

#opensource #vscode #devops #tutorial #azuresql #sql #sysadmin #copilot

0

Caricamento...

0
1

Caricamento...

Imagine building a login system that checks a user's email and password against a database.

Everything works perfectly until someone enters something

Altro...

Imagine building a login system that checks a user's email and password against a database.

Everything works perfectly until someone enters something unexpected into the login form.

Suddenly, your application is executing SQL commands you never intended.

That's the danger of SQL Injection (SQLi), one of the oldest and most dangerous vulnerabilities in web application security.

What Is SQL Injection?
SQL Injection is a security vulnerability that occurs when an application allows untrusted input to change the structure of a SQL query.

Instead of treating user input as data, the database ends up interpreting parts of it as SQL instructions.

Depending on the vulnerability and database permissions, attackers might be able to:

Access sensitive information.

Bypass authentication.

Modify or delete records.

Execute unauthorized database operations.

The underlying problem is simple: the application fails to separate data from executable SQL.

How Does SQL Injection Work?
Consider a C# application that retrieves a user from a database.

var query = $"SELECT * FROM Users WHERE Email = '{email}'";

At first glance, this looks reasonable.

If the user enters:

john@example.com

The resulting query becomes:

SELECT * FROM Users
WHERE Email = 'john@example.com';

Everything works as expected.

But what happens if someone enters:

' OR 1=1 --

Your application constructs:

SELECT * FROM Users
WHERE Email = '' OR 1=1 --';

Here's what happens:

The first ' closes the string.

OR 1=1 introduces a condition that is always true.

-- comments out the remaining SQL.

Instead of retrieving one specific user, the database may return every user.

And if an application's authentication logic incorrectly trusts that result, the consequences can be even worse.

How Do You Prevent SQL Injection? 1. Use Parameterized Queries
The most important defense is to separate SQL commands from user-supplied values.

Instead of concatenating strings:

var query = $"SELECT * FROM Users WHERE Email = '{email}'";

Use parameters:

using var command = new NpgsqlCommand(
"SELECT * FROM Users WHERE Email = @email",
connection
);

command.Parameters.AddWithValue("email", email);

using var reader = await command.ExecuteReaderAsync();

Now, even if someone enters malicious SQL syntax, the database treats it as a value rather than executable SQL.

The query structure stays unchanged.

  1. Use an ORM Like Entity Framework Core
    If you're working with .NET, Entity Framework Core makes it easier to write queries safely.

var user = await context.Users
.FirstOrDefaultAsync(u => u.Email == email);

EF Core translates this LINQ expression into a parameterized SQL query.

However, using an ORM doesn't automatically eliminate every SQL Injection risk.

For example, this is still dangerous:

var users = await context.Users
.FromSqlRaw(
$"SELECT * FROM Users WHERE Email = '{email}'"
)
.ToListAsync();

The safer approach is:

var users = await context.Users
.FromSqlInterpolated(
$"SELECT * FROM Users WHERE Email = {email}"
)
.ToListAsync();

Here, EF Core converts the interpolated value into a database parameter.

Important: FromSqlRaw can also be safe when used correctly with explicit parameters. The vulnerability comes from inserting untrusted values directly into SQL text.

  1. Apply the Principle of Least Privilege
    Your application shouldn't connect to the database using an account with unnecessary administrative permissions.

For example, if a service only needs to read records, its database account shouldn't have permission to delete tables.

This doesn't prevent SQL Injection itself, but it can significantly reduce the damage if a vulnerability is exploited.

  1. Validate Input, but Don't Rely on Validation Alone
    Input validation is important.

You can validate email formats, enforce length limits, and reject unexpected values.

However, validation is not a replacement for parameterized queries.

Attackers can find ways around weak validation rules, but properly parameterized values cannot alter the SQL query structure.

The Key Takeaway
SQL Injection isn't really about attackers knowing clever SQL commands.

It's about an application allowing user-controlled data to become executable instructions.

Whether you're using raw SQL, Dapper, ADO.NET, or Entity Framework Core, the principle remains the same:

Never build SQL queries by concatenating untrusted input.

Use parameterized queries, limit database permissions, and treat every external input as untrusted.

Because sometimes, the difference between a secure application and a database breach is how you construct a single SQL query.
SQL Injection: When User Input Becomes a Database Command

#cybersecurity #software #coding #sql #community #engineering #security #development #inclusive #database

0

Caricamento...

0
1

Caricamento...

Reading the CVSS 9.8 score of CVE-2026-108474 without overreading it ...

Altro...

Reading the CVSS 9.8 score of CVE-2026-108474 without overreading it ...
Reading the CVSS 9.8 score of CVE-2026-108474 without overreading it

#cybersecurity #software #coding #sql #community #engineering #security #development #inclusive #database

0

Caricamento...

0
1

Caricamento...

VS Code MSSQL 1.46: SQL Agent Skills e formatter GA per sviluppatori .NET

Un’estensione che cambia pelle: da editor SQL a hub per agenti AICon la versione 1.46, rilasciata il 28 settembre 2026, l’estensione MSSQL per Visual

Altro...

Un’estensione che cambia pelle: da editor SQL a hub per agenti AICon la versione 1.46, rilasciata il 28 settembre 2026, l’estensione MSSQL per Visual Studio Code compie un passo che va ben oltre il consueto giro di bugfix. Microsoft porta a disponibilità generale (GA) il nuovo Formatter e, soprattutto, introduce un meccanismo di onboarding pensato per collegare in un solo click l’estensione alle Microsoft SQL Agent Skills, un pacchetto di competenze specialistiche per (e non solo) dedicato allo sviluppo, alla migrazione e alla gestione di database SQL Server e Azure SQL.

Per chi lavora ogni giorno con T-SQL, Entity Framework o pipeline di migrazione verso il , questa merita attenzione: non si tratta di un ennesimo assistente generico, ma di un sistema di “skill” specializzate che l’agente carica automaticamente in base al contesto della richiesta, senza sintassi speciale da imparare.

Cosa cambia in pratica nella versione 1.46Il changelog ufficiale del rilascio 1.46.0 elenca diverse novità, ma tre sono quelle rilevanti per un pubblico tecnico:

SQL Formatter GA: il formattatore T-SQL, finora in anteprima, diventa stabile e offre maggiore controllo su stile e layout del codice, utile per standardizzare gli script tra i membri di un team.

Getting Started page: una nuova pagina guidata (in preview) che centralizza l’installazione delle SQL Agent Skills con un click, i template per i di sviluppo locale e i percorsi di apprendimento guidato.

Notifiche audio: le query di lunga esecuzione possono ora segnalare il completamento con un suono, configurabile tramite mssql.query.playCompletionSound e mssql.query.completionSoundFile — piccolo dettaglio ma utile per chi lancia migrazioni di dati che richiedono minuti.

Si aggiungono inoltre miglioramenti a Schema Compare (filtri per tipo di oggetto), al Data API Builder (configurazioni di deployment persistenti, supporto alle colonne vector e json) e all’esportazione dei risultati dai SQL Notebook, che ora permette di copiare i dati come CSV, JSON, istruzioni INSERT INTO o elenchi per clausole IN.

Configurare le notifiche audioPer chi gestisce query batch pesanti, ecco un esempio di configurazione da aggiungere al file settings.json di VS Code:

{
"mssql.query.playCompletionSound": true,
"mssql.query.completionSoundFile": "default"
}
Le SQL Agent Skills: cosa sono davveroIl pezzo più interessante della release non è nell’estensione in sé, ma nel repository microsoft/microsoft-sql, che raccoglie i plugin installabili per agenti di coding pubblicati dal team prodotto di Microsoft SQL. Non è un singolo assistente, ma un insieme di cinque plugin specializzati:

microsoft-sql: competenze generali di sviluppo e gestione operativa su SQL.

microsoft-azuresqldb-container: workflow per lo sviluppo locale con database containerizzati.

microsoft-sql-vscode: integrazione specifica con l’estensione MSSQL di VS Code.

microsoft-sql-migration: assistenza per la migrazione da SQL Server on-premise ad Azure.

microsoft-sql-fdh: analisi dell’inventario e della sicurezza in Fabric Database Hub.

Il punto tecnico interessante è che questi plugin non sono legati esclusivamente a GitHub Copilot: il repository dichiara compatibilità anche con Claude Code, OpenAI Codex CLI, Cursor e Grok Build, segno che Microsoft sta puntando su uno standard di “agent skills” trasversale piuttosto che su un ecosistema chiuso.

Installazione delle skill nei diversi agentiL’installazione varia leggermente a seconda dell’agente utilizzato. Per GitHub Copilot CLI:

copilot plugin marketplace add microsoft/microsoft-sql
copilot plugin install microsoft-sql@microsoft-sql
Per Claude Code:

/plugin marketplace add microsoft/microsoft-sql
Per Cursor:

cursor-agent plugin marketplace add https://github.com/microsoft/microsoft-sql
Una volta installate, le skill vengono richiamate automaticamente in base al contesto della richiesta: non serve un prompt speciale. Un esempio citato nella documentazione è la richiesta in linguaggio naturale “connetti la mia app Node ad Azure SQL Database senza password”, che attiva la skill dedicata all’autenticazione con Microsoft Entra e alle managed identity — un tema che i lettori di questo blog conoscono già bene, essendo già stato trattato negli articoli su identità di workload e Managed Identity.

Cosa copre nel dettaglio l’insieme delle skillAl di là dei nomi dei plugin, le competenze incluse coprono un ventaglio di problemi molto concreti per chi lavora quotidianamente con SQL Server e Azure SQL:

Progettazione dello schema e migrazioni sicure (con generazione di script di rollback);

Autenticazione e sicurezza, inclusi Microsoft Entra ID e la row-level security;

Diagnostica delle performance tramite Query Store ed execution plan;

Ricerca vettoriale e scenari di retrieval-augmented generation (RAG) su dati relazionali;

Automazione del deployment con Azure Functions;

Import/export dei dati e procedure di recovery;

Valutazione e validazione delle migrazioni verso il cloud.

Quest’ultimo punto, in particolare, rende la skill microsoft-sql-migration un candidato interessante per chi sta pianificando lo spostamento di carichi SQL Server on-premise verso Azure SQL Managed Instance, un processo che tradizionalmente richiede settimane di assessment manuale con strumenti come il Data Migration Assistant.

Come iniziareIl percorso più rapido per provare tutto insieme è aggiornare l’estensione MSSQL all’ultima versione dal Marketplace di VS Code, aprire la nuova pagina “Getting Started” (accessibile dalla command palette) e da lì installare le skill con un click. È necessaria una sottoscrizione a GitHub Copilot attiva; una volta connessi a un database (SQL Server 2025, Azure SQL o SQL Database in Fabric), è sufficiente fare clic destro sul database e selezionare “Chat with this database” per iniziare a interagire in linguaggio naturale.

Per chi gestisce ambienti misti on-premise/cloud, vale la pena testare prima le skill in un container di sviluppo locale (workflow coperto dal plugin microsoft-azuresqldb-container) prima di applicarle a database di produzione: la generazione automatica di script DDL, per quanto assistita, va sempre validata da un DBA prima dell’esecuzione.

ConclusioneLa release 1.46 dell’estensione MSSQL conferma una tendenza che i sistemisti e gli sviluppatori .NET faranno bene a monitorare: l’AI assistita non si limita più al completamento del codice, ma si sta strutturando in “competenze” verticali, installabili e portabili tra agenti diversi. Per i team che gestiscono database SQL Server e Azure SQL, le nuove SQL Agent Skills rappresentano un punto di partenza concreto per automatizzare compiti ripetitivi — dalla scrittura di query alla pianificazione di migrazioni — mantenendo però la revisione umana come passaggio obbligato prima di ogni modifica su ambienti critici.

Fonte: Azure SQL Dev Corner – Microsoft DevBlogs e note di rilascio ufficiali su GitHub.

#vscode #howto #tutorial #net #azure #azuresql #sql #dev #copilot

2

Caricamento...

0
1

Caricamento...

Azure SQL Managed Instance: addio alla quota regionale unica, ora i limiti sono per famiglia hardware

Il problema: quote regionali condivise e capacity planning complicatoChi gestisce ambienti Azure SQL Managed Insta

Altro...

Il problema: quote regionali condivise e capacity planning complicatoChi gestisce ambienti Azure SQL Managed Instance (MI) su larga scala conosce bene un problema che, fino a pochi giorni fa, complicava ogni fase di dimensionamento: le quote regionali di subnet. Ogni Managed Instance deve risiedere in una subnet dedicata e delegata al servizio, e fino ad oggi il numero massimo di vCore utilizzabili in quella subnet era vincolato a una quota unica per regione e sottoscrizione, condivisa indistintamente tra tutte le generazioni hardware disponibili (Standard-series, Premium-series e Premium-series Memory Optimized).

In pratica, se un team aveva già saturato la quota regionale con istanze su hardware Standard-series, non poteva provisionare una nuova istanza Premium-series nella stessa regione senza prima aprire una richiesta di supporto per l’aumento della quota, anche se la subnet stessa aveva ancora IP disponibile. Un vincolo “trasversale” che poco aveva a che fare con la reale capacità di rete e molto con una limitazione amministrativa lato piattaforma, particolarmente dolorosa per chi gestisce deployment multi-tenant, ambienti di disaster recovery con failover group, o strategie di aggiornamento side-by-side che richiedono temporaneamente il doppio delle risorse.

Cosa cambia: quote per generazione hardware, non più una quota unicaMicrosoft ha annunciato il passaggio a un modello di limiti semplificati e granulari: la quota regionale condivisa viene sostituita da quote indipendenti per ciascuna famiglia hardware. In altre parole, i vCore disponibili per Standard-series, quelli per Premium-series e quelli per Premium-series Memory Optimized vengono ora contabilizzati separatamente, e i deployment sono governati dai normali limiti di rete virtuale di Resource Manager (ARM) piuttosto che da un vincolo specifico del servizio MI.

Il cambiamento si applica sia ai deployment single-zone sia a quelli zone-redundant, e riguarda tutte le subnet delegate a Microsoft.Sql/managedInstances. Per i clienti esistenti la transizione è trasparente: le quote regionali di vCore attualmente in uso vengono convertite automaticamente nel nuovo modello per-hardware, senza necessità di riconfigurare le istanze già in esercizio.

Perché è rilevante per chi fa capacity planningRichieste di quota più mirate: se serve solo più capacità Premium-series Memory Optimized, non è più necessario negoziare un aumento che finirebbe per “gonfiare” anche lo spazio per le altre famiglie hardware.

Pianificazione degli upgrade side-by-side più semplice: le operazioni che richiedono capacità aggiuntiva temporanea (ad esempio il passaggio da hardware Gen5 legacy a Standard-series) impattano ora solo la quota della famiglia hardware coinvolta.

Meno attrito nei deployment multi-team: in sottoscrizioni condivise tra più team o applicazioni, un consumo intensivo di una famiglia hardware non blocca più il provisioning su un’altra famiglia nella stessa regione.

Cosa resta invariato: il dimensionamento della subnetÈ importante non confondere questo cambiamento con un allentamento dei requisiti di rete: la subnet dedicata a Managed Instance deve continuare a rispettare i vincoli storici del servizio. Microsoft continua a raccomandare un blocco CIDR di almeno /27 (32 indirizzi) per garantire margine sufficiente a operazioni di manutenzione, failover e scaling, con /28 come limite minimo assoluto per ambienti realmente contenuti. Restano inoltre valide le regole che vietano di condividere la subnet con altre risorse non delegate e che richiedono una tabella di route e un gruppo di sicurezza di rete (NSG) dedicati e configurati secondo i requisiti del servizio.

Per chi deve verificare lo stato attuale delle quote, il percorso resta quello consueto tramite portale Azure, sotto Subscriptions > Usage + quotas filtrando per il provider Microsoft.Sql, oppure via Azure CLI:

az sql instance-pool list-usage --location "westeurope"

oppure, per verificare i limiti di risorsa applicabili a una specifica instance pool

az sql instance-pool show --name mypool --resource-group myRGLe richieste di aumento quota, quando necessarie, si effettuano ancora tramite una richiesta di supporto dedicata dal portale Azure, specificando ora la famiglia hardware interessata anziché una generica richiesta regionale.

Considerazioni pratiche per l’infrastrutturaPer chi sta pianificando una migrazione verso Managed Instance, o un ampliamento di un ambiente esistente, questo è un buon momento per rivedere la topologia di rete. Alcuni suggerimenti operativi:

Documentate quale famiglia hardware ciascuna istanza nel vostro inventario CMDB o nei tag delle risorse: con quote separate, sapere “chi consuma cosa” diventa più rilevante per prevedere colli di bottiglia futuri.

Rivedete le pipeline di provisioning IaC (Bicep, , ARM template): se avevate logica custom per gestire manualmente errori di quota condivisa, potete probabilmente semplificarla.

Pianificate in anticipo gli upgrade di generazione hardware: sapere che la quota Premium-series è indipendente da quella Standard-series consente di programmare finestre di migrazione senza il rischio che un’altra applicazione “consumi” involontariamente la capacità necessaria.

Verificate i failover group cross-region: assicuratevi che anche nella regione secondaria la quota per la famiglia hardware utilizzata sia sufficiente, dato che il DR richiede risorse equivalenti a quelle primarie.

ConclusioneSi tratta di una modifica infrastrutturale che non introduce nuove funzionalità visibili agli sviluppatori, ma che rimuove un attrito operativo reale per chi amministra ambienti Azure SQL Managed Instance su larga scala. Il passaggio da una quota condivisa a quote per hardware allinea meglio la governance delle risorse SQL a quella già in uso per il resto della rete virtuale, riduce le richieste di supporto necessarie per operazioni di routine e semplifica la pianificazione di capacity planning e upgrade. Per i team che gestiscono più applicazioni con esigenze hardware eterogenee nella stessa sottoscrizione, il beneficio pratico si vedrà già alla prossima richiesta di provisioning.

Fonte: Petri IT Knowledgebase – Azure SQL Managed Instance Removes a Capacity Planning Hurdle for Large Deployments

#azure #azuresql #sql

0

Caricamento...

0
1

Caricamento...

SQL Server su VM Azure: la migrazione via Azure Arc è ora GA, ecco come funziona

Chi gestisce ambienti SQL Server on-premises conosce bene il problema: la migrazione verso il cloud richiede quasi sempre di mettere insieme tool dive

Altro...

Chi gestisce ambienti SQL Server on-premises conosce bene il problema: la migrazione verso il cloud richiede quasi sempre di mettere insieme tool diversi per la valutazione, il trasferimento dei dati, il monitoraggio e infine il cutover. Ogni fase ha strumenti propri, competenze diverse e margini di errore che si sommano. Con l’annuncio della disponibilità generale (GA) della migrazione a SQL Server su macchine virtuali Azure tramite Azure Arc, Microsoft porta l’intero ciclo di vita della migrazione dentro un’unica esperienza guidata nel portale Azure, lo stesso modello già usato per le migrazioni verso Azure SQL Managed Instance.

Per chi amministra data center misti, con carichi legacy e SQL Server sparsi su fisico e virtuale, questa novità merita attenzione: non è solo un annuncio di marketing, ma un cambio concreto di flusso di lavoro operativo.

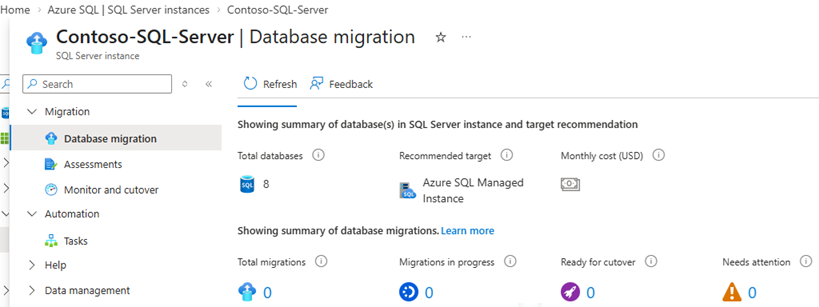
Cos’è cambiato con la GAFino a poco tempo fa, chi voleva spostare un’istanza SQL Server su una VM Azure doveva combinare Azure Migrate, Database Migration Service e strumenti di backup/restore manuali, gestendo ciascuno con logiche e dashboard separate. Con la funzionalità di migrazione integrata in Azure Arc, il processo si consolida in quattro fasi accessibili da un singolo pannello, il Database Migration, associato all’istanza SQL Server abilitata da Arc:

Assess source instance — valutazione di leggibilità e readiness dell’istanza sorgente

Select target — scelta o creazione della VM SQL Server di destinazione

Migrate data — trasferimento effettivo dei database

Monitor and cutover — monitoraggio della sincronizzazione e passaggio finale in produzione

La discovery delle istanze e la generazione dei report di readiness avvengono automaticamente ogni fine settimana, ma possono essere lanciate anche manualmente, senza configurazioni aggiuntive: la funzione è disponibile di default per tutte le istanze SQL Server abilitate da Arc a partire da SQL Server 2012 (11.x).

Copilot integrato nel flusso di migrazioneUna parte interessante della nuova esperienza è l’integrazione di Microsoft Copilot direttamente nel pannello di migrazione. Non si tratta di un chatbot generico: interroga la knowledge base Microsoft nel contesto specifico della vostra migrazione e risponde a richieste operative come:

Come vengono eseguite le valutazioni?
Aiutami a confrontare le opzioni di destinazione
Avvia la migrazione
Aiutami a scegliere il metodo di migrazione corretto
Monitora la migrazione in corso
Completa la migrazionePer un DBA che gestisce decine di istanze, questo significa poter chiedere direttamente nel pannello “quale VM SKU è consigliata per questo carico?” invece di andare a cercare tabelle di sizing nella documentazione.

Come funziona la migrazione via backup e restoreIl meccanismo sotto il cofano non è nuovo per chi ha familiarità con le migrazioni SQL Server classiche: si basa su backup e restore con log shipping continuo, pensato per supportare scenari di migrazione online con downtime minimo.

Viene eseguito un backup completo del database sorgente

Il backup viene caricato su un account di Azure Blob Storage intermedio

Il backup viene ripristinato sull’istanza SQL Server target sulla VM Azure

I backup dei log delle transazioni vengono caricati in continuo sullo stesso storage e applicati automaticamente al database target, mantenendolo sincronizzato

Al momento del cutover, Azure Arc applica l’ultimo backup caricato e porta online il database target

Un vincolo operativo da tenere a mente in fase di progettazione: l’account di Azure Blob Storage e la VM SQL Server target devono trovarsi nella stessa region Azure. È un dettaglio facile da trascurare se si pianifica la migrazione partendo dalla region “storica” dell’organizzazione invece che da quella scelta per il nuovo carico.

Prerequisiti praticiUna subscription Azure attiva

L’istanza SQL Server deve essere abilitata da Azure Arc con l’estensione più recente installata (l’estensione si aggiorna indipendentemente da SQL Server, quindi va controllata separatamente)

L’ambiente sorgente preparato secondo le linee guida ufficiali, incluso l’upload iniziale dei backup nello storage account

Per verificare rapidamente la versione dell’istanza sorgente prima di avviare l’assessment, un semplice controllo T-SQL è sempre un buon punto di partenza:

SELECT SERVERPROPERTY('ProductVersion') AS Versione,
SERVERPROPERTY('Edition') AS Edizione,
SERVERPROPERTY('EngineEdition') AS TipoMotore;Cosa considerare prima di partireIl pannello di monitoraggio e cutover mostra in tempo reale quali database sono migrati con successo, quali sono ancora in corso, il metodo di migrazione scelto, la durata della sincronizzazione e i log dettagliati. Quando lo stato passa a “Ready for cutover”, si può decidere il momento esatto del passaggio in produzione selezionando Cutover, con opzioni diverse in base al metodo di migrazione utilizzato.

Va detto che, come per ogni migrazione basata su backup/restore, restano da valutare a parte gli aspetti di sizing della VM di destinazione (storage, IOPS, memoria per il buffer pool), la licenza SQL Server (Hybrid Benefit se applicabile) e la strategia di alta disponibilità post-migrazione, che questo strumento non copre direttamente ma per cui l’assessment fornisce indicazioni.

ConclusionePortare discovery, assessment, migrazione e monitoraggio in un’unica dashboard riduce sensibilmente l’attrito operativo delle migrazioni SQL Server verso Azure, soprattutto per i team che gestiscono ambienti ibridi complessi con decine o centinaia di istanze. Non elimina la necessità di pianificazione — region, sizing e licensing restano decisioni da prendere a monte — ma consolida in un solo posto ciò che prima richiedeva più tool scollegati tra loro. Per chi ha già istanze abilitate da Azure Arc, vale la pena aggiornare l’estensione e lanciare un primo assessment anche solo per farsi un’idea della readiness del proprio parco macchine.

Fonte: Petri IT Knowledgebase e documentazione Microsoft Learn.

#microsoft #devops #guide #azure #azuresql #azurearc #sql #sysadmin

0

Caricamento...

0
1

Caricamento...