Vai al contenuto principale

#guide

Microsoft Defender for Endpoint sui desktop Linux: cosa cambia con la Public Preview

Da anni Microsoft for Endpoint protegge i server in produzione, ma fino a poco tempo fa le w

Altro...

Da anni Microsoft for Endpoint protegge i server in produzione, ma fino a poco tempo fa le workstation Linux restavano un punto cieco per molti team di sicurezza. È una lacuna che pesa soprattutto nelle aziende dove sviluppatori, e data engineer lavorano ogni giorno su o Fedora, spesso con privilegi elevati e accesso diretto a repository, pipeline CI/CD e credenziali . Con l’estensione in Public Preview del supporto ai desktop Linux, Microsoft chiude questo gap portando sulle workstation lo stesso stack EDR già maturo lato server.

Vediamo cosa cambia davvero, quali sono i requisiti aggiornati a ottobre 2026 e come impostare l’onboarding in pratica.

Cosa cambia con la Public PreviewLa novità principale non è tecnica ma di perimetro: tutte le distribuzioni già supportate sui server Linux lo sono ora anche sui desktop, con gli stessi pacchetti, gli stessi metodi di deployment e le stesse funzionalità di sicurezza. Non esiste quindi un “Defender per desktop” diverso da quello server: cambia solo la classificazione del dispositivo.

Defender for Endpoint assegna automaticamente a ogni macchina Linux il ruolo di Server o Workstation in base a diversi segnali di sistema (presenza di un ambiente desktop, pattern di utilizzo, ecc.). Se i segnali non sono conclusivi, il dispositivo viene classificato come Server per impostazione predefinita — un dettaglio da verificare subito dopo l’onboarding, perché incide direttamente sulla licenza richiesta:

Workstation: richiede una licenza Defender for Endpoint Plan 2, inclusa anche in Microsoft 365 E5 ed E7.

Server: richiede Defender for Servers Plan 1/2, Defender for Endpoint for Servers, oppure Defender for Business servers (solo PMI).

Le funzionalità disponibili includono antivirus, EDR completo, threat analytics e advanced hunting, vulnerability management, live response e device isolation, tutto centralizzato nella stessa console Defender usata per Windows e macOS.

Distribuzioni supportate e requisitiIl requisito minimo di kernel resta 3.10.0-327, con systemd richiesto come system manager (le varianti SystemV o Upstart non sono supportate). Per la device isolation servono iptables/ip6tables oppure le loro varianti -nft.

Distribuzionex64ARM64RHEL7.2+, 8.x, 9.x, 10.x8.x, 9.x, 10.xUbuntu LTS16.04 – 26.0420.04 – 26.04Debian9 – 1311, 12, 13SUSE Linux Enterprise12.x, 15.x, 16.x15 (SP5/SP6), 16.xFedora33 – 4440 – 44Oracle Linux, Rocky, AlmaLinuxsisiRequisiti hardware minimi: 1 vCPU, 1 GB di RAM e 2 GB di spazio disco (di più per carichi intensivi). Da notare un avviso di deprecazione: il supporto per Amazon Linux 2 su ARM64 termina il 31 ottobre 2026 — chi lo usa deve pianificare la migrazione subito.

Come fare l’onboardingIl flusso resta quello classico basato su repository Microsoft. Su una distribuzione RPM-based, ad esempio:

sudo yum install yum-utils
sudo yum-config-manager --add-repo=https://packages.microsoft.com/config/[distro]/[version]/[channel].repo
sudo rpm --import https://packages.microsoft.com/keys/microsoft.asc
yum makecache
sudo yum install mdatpdove [channel] è prod, insiders-fast o insiders-slow secondo le proprie esigenze di aggiornamento. Su Debian/Ubuntu la logica è identica con apt al posto di yum. Dopo l’installazione del pacchetto, va scaricato dal portale Defender (Impostazioni > Gestione dispositivi > Onboarding) il pacchetto di onboarding specifico ed eseguito sulla macchina per collegarla al tenant.

Per deployment su più macchine, Microsoft mette a disposizione il Defender Deployment Tool for Linux (GA da luglio 2026), che unifica installazione, onboarding, upgrade e disinstallazione, valida i prerequisiti, supporta repository locali e integra la Device Timeline. In alternativa, resta disponibile il repository microsoft/mdatp-xplat su GitHub con script pronti per Ansible e Puppet.

Verificare lo stato dell’agentemdatp health
mdatp health --field real_time_protection_enabled
mdatp health --field org_id
mdatp health --field cloud_enabled
mdatp health --field definitions_statusTestare il rilevamentocurl -o ~/eicar.com.txt https://www.eicar.org/download/eicar.com.txt
mdatp threat listSe la protezione in tempo reale è attiva, il file EICAR viene intercettato e messo in quarantena immediatamente, e l’incidente compare nel portale Defender.

Attenzione a questi dettagli in produzioneFanotify: eseguire Defender insieme ad altre soluzioni basate su fanotify in modalità blocking (diversa da FAPolicyD su RHEL/Fedora) non è supportato e può causare comportamenti imprevedibili, inclusi blocchi del sistema. In questi casi occorre impostare l’antivirus in modalità passive.

Utente mdatp: l’installazione crea un utente di sistema con UID/GID casuali. Se serve un valore prevedibile (ad esempio per policy di hardening), va creato manualmente prima dell’installazione con shell /usr/sbin/nologin.

Proxy: sono supportati solo proxy statici o trasparenti. PAC, WPAD, proxy con autenticazione e SSL inspection non sono supportati: per l’ispezione SSL va creata un’eccezione che lasci passare il traffico diretto verso gli URL di Defender.

ConclusionePer i team che gestiscono flotte Linux miste tra server e workstation di sviluppo, questa estensione chiude un divario di visibilità reale: avere EDR, vulnerability management e device isolation anche sui laptop degli sviluppatori — spesso il vettore più sottovalutato — significa poter correlare un’anomalia su una workstation con un incidente osservato sui server, nella stessa console. Essendo ancora in Public Preview, vale la pena pilotarla su un gruppo di macchine non critiche prima di estenderla a tutta la flotta, verificando in particolare la classificazione automatica server/workstation e l’impatto di eventuali altre soluzioni basate su fanotify.

Fonte: Petri.com – Microsoft Brings Defender for Endpoint to Linux Desktops in Public Preview, con dati tecnici aggiornati dalla documentazione ufficiale Microsoft Learn.
#sicurezza #linux #microsoft #guide #howto #tutorial #defender

0

Caricamento...

0
2

Caricamento...

XSLT disattivato in Edge da dicembre: come evitare che RD Web Access smetta di funzionare

A metà dicembre 2026 Microsoft 159 disattiverà per impostazione predefinita il supporto nativo a

Altro...

A metà dicembre 2026 Microsoft 159 disattiverà per impostazione predefinita il supporto nativo a nel , con che si muove in parallelo. Per la maggior parte dei siti moderni il cambiamento passerà inosservato, ma per chi gestisce infrastrutture Server con RD Access il rischio è concreto: l’interfaccia di accesso remoto dipende ancora da XSLT per il rendering, e senza interventi potrebbe smettere di caricarsi dall’oggi al domani. Vediamo cosa cambia, perché Microsoft lo sta facendo e quali contromisure adottare prima della scadenza.

Perché XSLT viene eliminato dai browserXSLT (eXtensible Stylesheet Language Transformations) è lo standard, nato a cavallo degli anni 2000, che permette di trasformare documenti XML in HTML, testo o altri formati XML direttamente lato client, tramite l’API JavaScript XSLTProcessor o una processing instruction XML che referenzia un foglio di stile .xsl. Nei browser basati su Chromium (e quindi anche in Edge) l’elaborazione XSLT è gestita da libxslt, una libreria nativa scritta in C che non riceve aggiornamenti sostanziali da anni.

Il problema è proprio questo: libxslt elabora contenuti XML potenzialmente non attendibili con un motore nativo datato, ampliando la superficie d’attacco a fronte di un utilizzo ormai marginale nel web moderno, dove le trasformazioni XML→HTML si fanno quasi sempre lato server o con librerie JavaScript. Microsoft e hanno quindi deciso, in coordinamento, di rimuovere il motore nativo e lasciare che siano gli sviluppatori a migrare verso alternative più sicure.

Le date da segnare in calendarioIl rollout è scaglionato in due fasi distinte, comunicate da Microsoft tramite il Message Center (riferimento MC1509789):

Edge 159 (metà dicembre 2026): XSLT nativo disattivato per impostazione predefinita, worldwide, inclusi gli ambienti GCC, GCC High e DoD. Resta disponibile una policy temporanea per riattivarlo.

Edge 176 (estate 2027): rimozione completa della policy temporanea e del motore XSLT. Da questo momento non ci sarà più alcun modo di riabilitarlo lato browser.

Sono coinvolti l’oggetto XSLTProcessor e le processing instruction XML che puntano a fogli di stile XSLT; quelle che referenziano CSS non sono interessate. Un avviso precedente (MC1491832) aveva già segnalato, per metà novembre 2026, rischi di rendering failure legati a XSLT su RD Web Access: le tempistiche comunicate da Microsoft in annunci diversi non sono sempre perfettamente allineate, quindi conviene considerare dicembre 2026 come finestra di sicurezza entro cui completare la verifica, senza aspettare l’ultimo giorno.

Il caso concreto: RD Web Access su Windows ServerIl portale RD Web Access (Accesso Web ai Desktop remoti), componente dei Servizi Desktop remoto su Windows Server, utilizza ancora XSLT per il rendering lato client delle pagine. Quando il browser disattiva XSLT, gli utenti che tentano di accedere al portale possono trovarsi di fronte a una pagina bianca, un errore di rendering o un comportamento anomalo nell’elenco di RemoteApp e desktop pubblicati. Microsoft ha pubblicato una nota di supporto dedicata (KB5130994, “RD Web Access fails to load when XSLT is disabled in Microsoft Edge or Google Chrome”) proprio per questo scenario.

È un impatto che riguarda una fetta minoritaria ma non trascurabile di organizzazioni: molte aziende italiane usano ancora RD Web Access per il lavoro remoto o per pubblicare applicazioni legacy, specialmente dove Virtual Desktop o soluzioni VDI più moderne non sono state ancora adottate.

Come verificare se la tua organizzazione è a rischioPrima di intervenire, conviene fare un inventario delle applicazioni interne che potrebbero dipendere da XSLT. Microsoft suggerisce di usare Lighthouse, integrato negli strumenti di sviluppo di Edge:

Apri l’applicazione da verificare in una versione aggiornata di Edge ed esegui l’accesso, se richiesto.

Premi F12 (o Ctrl+Shift+I) per aprire i DevTools, quindi seleziona il pannello Lighthouse (in “More tools” se non visibile).

Imposta Mode su Navigation e Category su Best Practices.

Per le applicazioni autenticate, disattiva l’opzione “Clear storage” nelle impostazioni di Lighthouse, così da non perdere la sessione.

Avvia “Analyze page load” e cerca nel report voci relative a XSLT, deprecated API o XSLTProcessor, controllando in particolare le sezioni “Uses deprecated APIs” e gli avvisi nel pannello Issues dei DevTools.

Ripeti il test per ogni pagina e flusso applicativo rilevante, non solo per la home page.

Per RD Web Access non serve nemmeno il test: se il server è ancora basato sui componenti classici dei Servizi Desktop remoto (non il nuovo client web HTML5), va messo in lista a prescindere.

Le tre strade per mettersi al riparo1. Riattivare temporaneamente XSLT con la policy XSLTEnabledÈ la soluzione tampone più rapida, pensata per guadagnare tempo mentre si pianifica la migrazione vera e propria. La policy XSLTEnabled è disponibile sia per Edge sia, con lo stesso nome, per Chrome.

Da riga di comando elevata (Prompt dei comandi come amministratore), per Edge:

reg add "HKLM\SOFTWARE\Policies\Microsoft\Edge" /v XSLTEnabled /t REG_DWORD /d 1 /fPer Chrome:

reg add "HKLM\SOFTWARE\Policies\Google\Chrome" /v XSLTEnabled /t REG_DWORD /d 1 /fIn alternativa, tramite Criteri di gruppo (GPO), su un ambiente di dominio:

Apri la Console di gestione dei criteri di gruppo e modifica (o crea) il GPO da applicare ai server/client interessati.

Vai in Configurazione computer → Modelli amministrativi → Microsoft Edge (il template ADMX è MSEdge.admx, da importare nel repository centrale se non già presente).

Apri la voce Control the availability of the XSLT feature, impostala su Enabled e salva.

Collega il GPO all’unità organizzativa che contiene i server RD Web Access o i client interessati, poi forza l’aggiornamento con gpupdate /force.

Importante: la policy è temporanea e verrà rimossa con Edge 176 (estate 2027) insieme al motore XSLT, quindi non va considerata una soluzione definitiva ma solo una finestra per completare la migrazione.

  1. Migrare al client web HTML5 di Desktop remotoLa soluzione strutturale per RD Web Access è passare al client web moderno, che non dipende da XSLT. È raggiungibile all’indirizzo:

https://<nome_server_rdweb>/RDWeb/webclient/index.htmlsostituendo <nome_server_rdweb> con l’FQDN del server. Il client HTML5 richiede però una configurazione preliminare lato server (ruolo RD Web Access aggiornato, certificati validi, eventuale pubblicazione tramite RD Gateway) che va pianificata e testata prima del passaggio in produzione: non è un semplice cambio di URL da comunicare agli utenti.

  1. Usare la modalità Internet Explorer di Edge come ripiegoPer scenari in cui non è possibile intervenire rapidamente sul server, Edge offre la modalità di compatibilità Internet Explorer, che Microsoft prevede di mantenere disponibile almeno fino al 2029:

Apri Impostazioni → Browser predefinito in Edge.

Attiva l’opzione “Consenti il ricaricamento dei siti in modalità Internet Explorer”.

Aggiungi l’URL del portale RD Web Access all’elenco “Pagine in modalità Internet Explorer”.

Al primo accesso il browser potrebbe chiedere di abilitare ActiveX, necessario per il single sign-on: un dettaglio da comunicare in anticipo agli utenti per evitare segnalazioni al service desk. È comunque solo un ponte verso una delle due soluzioni precedenti, non una destinazione finale.

Checklist operativa per i sysadminUn piano d’azione ragionevole prima di dicembre 2026:

Censire le applicazioni interne (RD Web Access incluso) che usano XSLT, con il test Lighthouse descritto sopra.

Applicare da subito, in via precauzionale, la policy XSLTEnabled sui server e client che accedono a RD Web Access, per evitare interruzioni impreviste al rollout di Edge 159.

Pianificare e testare in un ambiente non di produzione la migrazione al client web HTML5 di RD Web Access.

Per applicazioni custom con output XSLT lato client, valutare la trasformazione lato server o librerie JavaScript indipendenti dal motore nativo del browser.

Monitorare i prossimi annunci nel Message Center, perché le date comunicate finora non sono sempre coerenti tra loro.

ConclusioneLa rimozione di XSLT dai browser Chromium è un classico esempio di debito tecnico che arriva a scadenza: una tecnologia poco usata ma con una dipendenza nascosta in un componente critico come RD Web Access. Microsoft ha lasciato una finestra ragionevole e una policy di riattivazione temporanea per gestire la transizione senza fretta, ma come spesso accade la scadenza reale arriverà più vicina di quanto sembri: vale la pena verificare oggi, non a dicembre, se la propria infrastruttura è tra quelle a rischio.

Fonte: 4sysops.com, con riferimenti a Microsoft Message Center (MC1509789, MC1491832) e Microsoft Learn.

#browser #guide #howto #windowsserver #edge #remotedesktop #xslt

0

Caricamento...

0
1

Caricamento...

Certification Authority sul domain controller: si può fare, ma è una buona idea?

È una delle domande più ricorrenti — e più controverse — tra chi gestisce Active Directory da anni: si può

Altro...

È una delle domande più ricorrenti — e più controverse — tra chi gestisce Active Directory da anni: si può installare il ruolo Certification Authority direttamente su un domain controller? La risposta tecnica è sì, Microsoft lo supporta e Active Directory Certificate Services (AD CS) si integra perfettamente con un DC: template dei certificati, auto-enrollment e pubblicazione funzionano senza intoppi. Ma “supportato” non significa “consigliato”, e la differenza tra le due cose è esattamente il punto su cui vale la pena soffermarsi, perché tocca il cuore della progettazione di una aziendale.

Perché viene fatto comunque (e quando ha senso)Nella pratica, combinare CA e DC sullo stesso server capita più spesso di quanto si pensi, soprattutto in contesti con risorse limitate:

piccole aziende con uno o due domain controller in totale;

filiali remote con hardware e budget contenuti;

ambienti di laboratorio o di test;

scenari dove il certificato serve solo per usi interni (autenticazione LDAPS, smart card, qualche servizio intranet) senza requisiti di stringenti.

In questi casi, la strettissima integrazione con Active Directory semplifica davvero il deployment iniziale e riduce il carico amministrativo: non c’è un server aggiuntivo da patchare, monitorare e proteggere separatamente. Dal punto di vista del semplice funzionamento tecnico, non c’è nulla che impedisca questa configurazione.

Il problema: concentrare il rischio in un unico puntoIl motivo per cui la maggior parte delle linee guida di hardening sconsiglia questa combinazione non è un dettaglio tecnico, ma un principio di progettazione della sicurezza: un domain controller compromesso che è anche una CA espone contemporaneamente le credenziali di dominio, l’autenticazione di tutto il dominio, le chiavi private della CA e i diritti di emissione e revoca dei certificati. Un singolo attaccante che ottiene accesso privilegiato a quella macchina ottiene tutto in un colpo.

Ci sono poi due conseguenze meno ovvie, ma altrettanto importanti:

Il contenimento diventa più difficileRicostruire il domain controller da zero dopo un incidente non “ripristina la fiducia” nei certificati già emessi da quella CA: quei certificati restano validi (o da revocare uno per uno) indipendentemente da cosa succede al DC. Viceversa, ripristinare la CA da un non dimostra affatto che la directory sia ancora integra e non compromessa. Sono due problemi di fiducia distinti che, se il ruolo è unico, si trovano intrecciati nello stesso incidente di sicurezza.

Il recovery diventa accoppiatoSe la CA fallisce proprio durante la ricostruzione di un DC (o viceversa), si rischia di bloccare contemporaneamente la revoca urgente di certificati compromessi, il rinnovo e l’enrollment — con impatti diretti su VPN, Wi-Fi aziendale, autenticazione tramite smart card, certificati dei dispositivi e servizi TLS interni. In un’emergenza, avere due sistemi critici che devono essere ripristinati insieme nell’ordine giusto è l’ultima cosa che si vuole gestire sotto pressione.

L’architettura PKI che scala davvero: la gerarchia a due livelliIl design che la maggior parte delle organizzazioni di dimensioni medio-grandi dovrebbe adottare è la classica gerarchia PKI a due livelli, pensata esattamente per separare i ruoli e isolare il rischio:

Root CA offline: non è mai joinata al dominio, viene accesa solo quando serve (tipicamente per emettere o rinnovare i certificati delle CA subordinate e pubblicare le CRL), e l’accesso fisico e logico è estremamente ristretto. È, di fatto, l’ancora di fiducia di tutta la PKI, e per questo resta isolata dal resto ’infrastruttura.

Issuing CA aziendale: normalmente un member server joinato al dominio ma non un domain controller. Si occupa dell’enrollment quotidiano, pubblica i certificati, supporta l’auto-enrollment e si integra con AD per i template — ma senza condividere il ruolo con l’autenticazione del dominio.

Su scala enterprise, a questo si aggiungono delle chiavi protetto dove opportuno (HSM o equivalente), ruoli amministrativi distinti tra chi gestisce AD e chi gestisce la PKI, e procedure testate — non solo scritte su un documento — per revoca, sostituzione delle chiavi e disaster recovery.

Come scegliere in base alla dimensione dell’organizzazioneNon esiste una risposta universale: la scelta corretta dipende dal contesto, e la linea guida pratica è questa:

Piccole organizzazioni: combinare CA e DC può essere un compromesso accettabile, a condizione che sia una scelta consapevole e non un effetto collaterale della pigrizia. Serve comunque: backup separati e testati del database della CA e della chiave privata, location di revoca (CRL/AIA) effettivamente raggiungibili, e una sequenza di recovery documentata e provata almeno una volta.

Organizzazioni di medie dimensioni: è il momento di passare a una issuing CA dedicata quando i certificati iniziano a supportare VPN, Wi-Fi, Network Policy Server (NPS) o autenticazione dei dispositivi, quando il volume di auto-enrollment cresce, o quando PKI e Active Directory devono poter essere ripristinati in modo indipendente l’uno dall’altro.

Grandi organizzazioni: qui la separazione dei ruoli non è un “nice to have” ma un requisito di fiducia e resilienza. Un’architettura PKI realmente separata (root offline + issuing CA dedicata, eventualmente più issuing CA per region o per business unit) è lo standard de facto.

Checklist operativa: cosa fare se le cose vanno maleChi si trova a gestire un ambiente con CA e DC combinati — per scelta o per eredità — dovrebbe avere già pronte due procedure di emergenza.

CA fallita su un domain controllerPreservare il sistema guasto e tutti i backup disponibili, senza sovrascrivere nulla prematuramente.

Confermare che un altro DC stia fornendo correttamente AD DS e DNS, per non trovarsi anche senza directory funzionante durante il recovery.

Ripristinare la CA solo da backup verificati come integri.

Verificare che le location AIA e CRL siano effettivamente raggiungibili dai client.

Pubblicare dati di revoca aggiornati, se necessario.

Testare enrollment e validazione dei certificati prima di dichiarare chiuso l’incidente.

Sospetto compromesso della chiave della issuing CAFermare immediatamente l’emissione di nuovi certificati.

Preservare le evidenze per l’analisi forense.

Sostituire il certificato e la chiave della CA emittente.

Identificare e revocare i certificati fraudolenti o potenzialmente compromessi.

Pubblicare informazioni di revoca aggiornate.

Rilasciare nuovi certificati a utenti, dispositivi e servizi impattati.

Un dettaglio spesso sottovalutato: i certificati dei domain controllerIndipendentemente da dove risiede la CA, i certificati emessi per i domain controller devono soddisfare requisiti precisi: supportare sia l’autenticazione server che quella client, includere il nome DNS corretto del DC, avere i key usage adeguati e fare riferimento a una location CRL effettivamente raggiungibile dai client che devono validarli. I requisiti esatti del template variano in base ai servizi coinvolti — LDAPS e sign-in tramite smart card, in particolare, hanno esigenze specifiche che vanno verificate caso per caso.

Cosa fare se si eredita un ambiente con CA e DC già combinatiNon è necessario smontare tutto in un weekend. Microsoft supporta la migrazione di una CA che preserva database, certificati, configurazione e chiavi private, quindi il percorso corretto è trattarla come un vero e proprio progetto PKI pianificato — valutando criticità del business, obblighi di compliance, piani di espansione dei certificati e il livello di rischio accettabile — magari approfittando di un refresh hardware già previsto per farlo con il minimo impatto operativo.

ConclusioneLa domanda “posso installare la CA sul domain controller?” ha una risposta tecnica semplice (sì) e una risposta di design molto più sfumata (dipende, ma per la maggior parte delle organizzazioni in crescita la risposta pratica è no). Il punto da ricordare è che la supportabilità di Microsoft non equivale a una buona architettura: è una scelta che concentra rischio, complica il contenimento degli incidenti e accoppia il recovery di due sistemi critici che, idealmente, dovrebbero poter fallire e essere ripristinati in modo indipendente. Per un laboratorio o una microazienda può essere un compromesso ragionevole, purché documentato; per tutto il resto, una issuing CA dedicata, separata dai domain controller, resta la base di una PKI che tiene quando serve davvero.

Fonte: Petri IT Knowledgebase – Should You Install Certificate Authority on a Domain Controller?

#sicurezza #windows #guide #activedirectory #pki

0

Caricamento...

0
1

Caricamento...

Grounding AI su SharePoint Embedded: come fare RAG senza creare un vector database

Il problema che tutti conosciamo: costruire un RAG è lento, non è l’app che vuoi fareChi ha provato a costruire un’applicazione AI “grounded” sui docu

Altro...

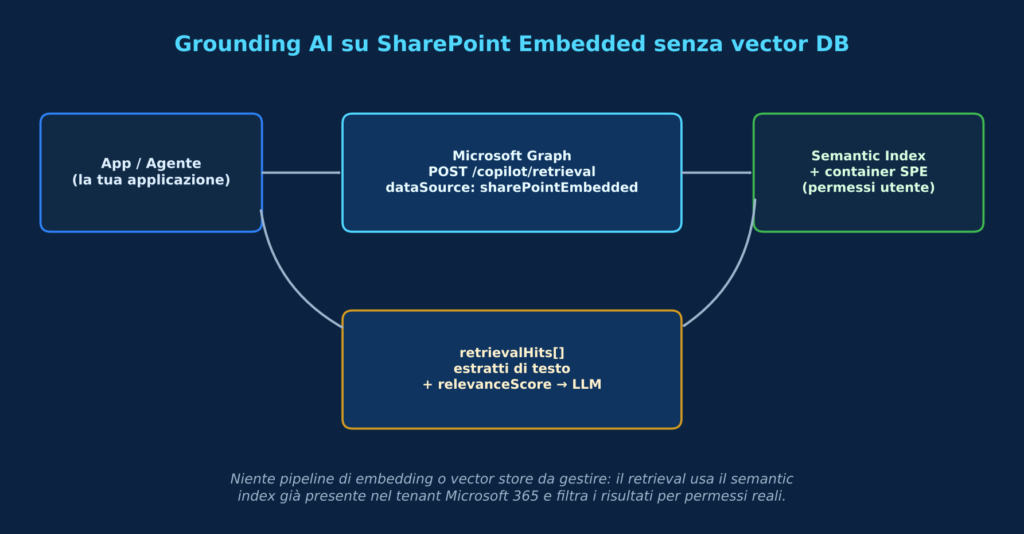
Il problema che tutti conosciamo: costruire un RAG è lento, non è l’app che vuoi fareChi ha provato a costruire un’applicazione AI “grounded” sui documenti aziendali conosce bene la lista di lavoro che precede la parte interessante: estrarre il testo dai file, suddividerlo in chunk, generare gli embedding, scegliere e gestire un vector database, sincronizzare periodicamente i contenuti e — il pezzo più trascurato e più rischioso — replicare a mano i permessi di accesso di ogni singolo utente su ogni singolo documento indicizzato. Microsoft ha pubblicato di recente una guida che affronta direttamente questo problema per chi costruisce su Embedded: niente vector database da creare, perché il retrieval passa attraverso un’API di Microsoft Graph che si appoggia al semantic index già presente nel tenant Microsoft 365.

Per chi non lo conoscesse, SharePoint Embedded è la variante “headless” di SharePoint pensata per gli sviluppatori: permette di usare lo , la sicurezza e la governance di SharePoint dentro un’applicazione personalizzata, senza l’interfaccia utente classica di SharePoint. I contenuti restano all’interno di nel tenant Microsoft 365 del cliente, e le policy di Microsoft (audit, eDiscovery, retention, DLP, sensitivity label, conditional access) si applicano automaticamente, senza bisogno di ricostruirle nell’app.

Due strade per il grounding, non una solaLa documentazione Microsoft distingue due approcci, a seconda di chi deve avere il controllo sull’orchestrazione:

Microsoft Foundry Agent Service con una knowledge source SharePoint: il retrieval è gestito interamente da Foundry come parte ’agente. Scelta naturale se l’agente è già costruito su Foundry.

Microsoft 365 Retrieval API: l’applicazione esegue da sé il passo di grounding, mantenendo il controllo completo su prompt, orchestrazione e scelta del modello generativo. È l’opzione da preferire per chi vuole costruire una pipeline RAG personalizzata senza rinunciare alla ricerca semantica gestita da Microsoft.

Come funziona la Retrieval API in praticaL’endpoint è parte di Microsoft Graph:

POST https://graph.microsoft.com/v1.0/copilot/retrieval
Content-Type: application/json
Authorization: Bearer {access_token}

{
"queryString": "Quali sono le clausole dell'accordo con Contoso?",
"dataSource": "sharePointEmbedded",
"dataSourceConfiguration": {
"sharePointEmbedded": {
"containerTypeId": "{containerTypeId}"
}
},
"maximumNumberOfResults": 10
}Alcuni dettagli tecnici rilevanti per chi deve integrarla:

Richiede un token delegato: le chiamate app-only (senza utente autenticato) non sono previste, e il permesso Graph necessario è FileStorageContainer.Selected.

I risultati restituiti sono già filtrati in base ai permessi reali dell’utente autenticato sui file in SharePoint Embedded: non serve replicare la logica di autorizzazione nell’app o nel vector store, il problema più insidioso di un RAG costruito da zero è risolto a monte.

È possibile restringere la ricerca con filterExpression, usando una sintassi KQL sulle managed property indicizzate (ad esempio ClientMatterCodeOWSTEXT="…" per una colonna di metadati personalizzata). Importante usare = per un match esatto: l’operatore : esegue un term matching più permissivo che può restituire prefissi o valori correlati non voluti.

Il parametro resourceMetadata permette di richiedere campi aggiuntivi (titolo, autore, metadati custom) per ogni risultato, a costo di un payload più pesante.

La risposta restituisce una collezione di retrievalHits, ciascuno con un webUrl opaco al file originale e uno o più extracts di testo ordinati per relevanceScore:

{
"retrievalHits": [
{
"webUrl": "https://contoso.com/spe/file",
"extracts": [
{
"text": "L'accordo si rinnova annualmente salvo preavviso di 30 giorni da una delle parti.",
"relevanceScore": 0.8421
}
]
}
]
}Da qui in poi il lavoro è quello consueto di un RAG: passare gli estratti come contesto al modello generativo scelto. Un esempio minimale in JavaScript per il passo di grounding:

const response = await fetch(
"https://graph.microsoft.com/v1.0/copilot/retrieval",
{
method: "POST",
headers: {
"Content-Type": "application/json",
Authorization: Bearer ${accessToken}
},
body: JSON.stringify({
queryString: query,
dataSource: "sharePointEmbedded",
dataSourceConfiguration: {
sharePointEmbedded: { containerTypeId }
}
})
}
);

const data = await response.json();
const grounding = (data.retrievalHits ?? []).map(hit => ({
url: hit.webUrl,
text: hit.extracts?.[0]?.text?.trim(),
score: hit.extracts?.[0]?.relevanceScore
}));
// grounding va passato come contesto al modello generativoPrerequisiti e fatturazione: cosa serve prima di iniziareUn’applicazione SharePoint Embedded con almeno un container e il relativo container type ID.

Fatturazione pay-as-you-go configurata sul container type, senza impegno minimo iniziale.

Almeno un utente del tenant con licenza Microsoft 365 Copilot: serve per inizializzare il semantic index, ma non è richiesta una licenza individuale per ogni utente che interroga poi la Retrieval API.

La proprietà discoverability deve essere abilitata sul container type: senza di essa i contenuti non sono visibili a Copilot, ed è un’impostazione governata a livello di tenant, non modificabile unilateralmente dall’app.

Le chiamate alla Retrieval API vengono fatturate tramite il Copilot Studio message meter, con due modelli possibili: standard billing (a carico del tenant che sviluppa l’app) o pass-through billing (a carico del tenant che la utilizza).

Da segnalare anche un dettaglio utile per chi vuole prototipare rapidamente: è disponibile in preview pubblica un server MCP open source (@microsoft/spe-mcp, avviabile con npx @microsoft/spe-mcp) che espone SharePoint Embedded come knowledge source a client compatibili come GitHub Copilot in VS Code, Copilot CLI, Claude e Cursor — utile per esplorare rapidamente i contenuti di un container durante lo sviluppo senza scrivere subito codice di integrazione.

Cosa cambia rispetto a un RAG “fatto in casa”Il compromesso è chiaro e va valutato con attenzione prima di adottarlo: si rinuncia al controllo diretto sulla pipeline di estrazione, chunking ed embedding — e quindi alla possibilità di personalizzarla finemente — in cambio dell’eliminazione di tre problemi che in un RAG self-hosted sono spesso sottovalutati in fase di progettazione: la gestione del ciclo di vita dell’indice, la sincronizzazione con i permessi reali dei file e i costi operativi di un vector database dedicato. Per team che lavorano già dentro l’ecosistema Microsoft 365 e che devono costruire agenti o assistenti su documentazione interna, è un’opzione che merita di essere valutata prima di investire tempo in un’infrastruttura RAG completamente custom — soprattutto quando il vincolo di conformità sui permessi è più critico della flessibilità del modello di retrieval.

Fonte: Microsoft 365 Developer Blog e documentazione Microsoft Learn.

#ai #intelligenzaartificiale #guide #howto #azure #copilot #sharepoint #microsoftgraph

0

Caricamento...

0
2

Caricamento...

Bash scripting per sistemisti: dai fondamentali agli script di produzione pronti per cron

Perché la maggior parte degli script bash “funziona sulla mia macchina” e poi fallisce in produzioneChiunque amministri sistemi ha almeno uno s

Altro...

Perché la maggior parte degli script bash “funziona sulla mia macchina” e poi fallisce in produzioneChiunque amministri sistemi ha almeno uno script scritto in dieci minuti per risolvere un problema urgente, che poi è finito silenziosamente in produzione tramite un cron job. Il problema è che uno script funzionale non è automaticamente uno script affidabile: la differenza si vede quando lo script gira senza terminale, senza nessuno che guarda l’output, magari in concorrenza con un’altra esecuzione dello stesso job.

In questo articolo ripassiamo rapidamente le basi della scrittura di script bash, ma ci concentriamo soprattutto su ciò che separa uno script “da developer” da uno pronto per l’automazione in un ambiente sistemistico reale: gestione degli errori, logging, locking e debugging.

Le fondamenta, in breveUno script bash è un file di testo con una sequenza di comandi che la shell esegue in ordine. La prima riga, lo shebang, indica al quale interprete usare:

#!/usr/bin/env bash
echo "Hello, world"Usare /usr/bin/env bash invece di /bin/bash hardcoded rende lo script più portabile su sistemi dove bash non risiede nel path standard (tipico su alcune distribuzioni minimali o ). Reso eseguibile con chmod +x script.sh, lo script si lancia con ./script.sh.

Variabili e quotingUna convenzione diffusa negli ambienti Linux è usare il maiuscolo per variabili globali/di configurazione e il minuscolo per variabili locali, evitando di sovrascrivere variabili di sistema come PATH, HOME o USER. La regola più importante, spesso ignorata, è: quotare sempre le variabili.

SITE="miosito.it"
DATE=$(date +%Y-%m-%d)
echo "Backup di $SITE il $DATE"Senza le virgolette, un valore contenente spazi o caratteri speciali può spezzare la logica dello script in modi difficili da diagnosticare, specialmente con percorsi di file.

Argomenti e parametri posizionaliif [ $# -lt 1 ]; then
echo "Uso: $0 "
exit 1
fi
FILE="$1"Per script più complessi, destinati a essere invocati con flag (-v, --dry-run), conviene usare getopts per le opzioni brevi, che gestisce automaticamente la validazione e i messaggi di errore standard, evitando il parsing manuale di $@ con cicli while annidati e propensi a bug.

Dove gli script “da sviluppatore” falliscono in produzione1. Modalità strict e i suoi limiti realiLa pratica più citata è attivare la modalità rigorosa in testa allo script:

set -euo pipefail-e: esce immediatamente se un comando termina con stato diverso da zero

-u: tratta le variabili non definite come errore

-o pipefail: propaga il fallimento anche a metà di una pipeline, non solo sull’ultimo comando

È una buona base, ma va usata sapendo dove non funziona: set -e viene ignorato all’interno delle condizioni di if, nelle catene &&/|| e in certi contesti di funzione. Inoltre pipefail può creare falsi positivi con comandi come grep (che esce con stato diverso da zero se non trova corrispondenze) o head (che chiude il descrittore a monte, generando l’exit code 141 su SIGPIPE). Se il vostro script fa comando | grep pattern dentro uno script in pipefail, uno “zero risultati” legittimo può far abortire l’intero job: va gestito esplicitamente, ad esempio con grep pattern || true quando l’assenza di match è un esito accettabile.

  1. Logging: se gira da cron, nessuno vede lo stdoutUno script lanciato da terminale che scrive con echo è inutile quando lo stesso script gira da cron: l’output, se non rediretto, o finisce in una mail di sistema che nessuno , o si perde. La soluzione minima è una funzione di logging centralizzata:

LOGFILE="/var/log/watchdog.log"

log() {
echo "[$(date '+%Y-%m-%d %H:%M:%S')] $1" >> "$LOGFILE"
}

log "Script avviato"Questo pattern, combinato con local per le variabili interne alle funzioni (evitando l’inquinamento dello scope globale), è alla base di quasi ogni script di automazione che vale la pena mettere in cron.

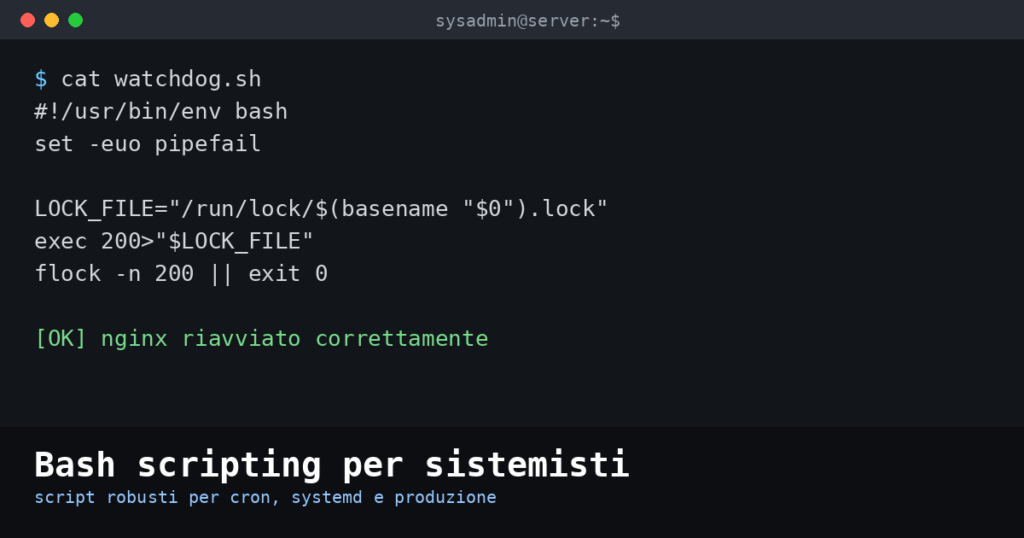
  1. Evitare esecuzioni concorrenti con flockUn errore classico: un job schedulato ogni minuto che, in caso di rallentamento (I/O lento, rete, dipendenza esterna), parte una seconda volta prima che la prima istanza sia terminata. Il modo standard per evitarlo su Linux è flock, che un file descriptor come lock a livello di kernel:

#!/usr/bin/env bash
set -euo pipefail

LOCK_FILE="/run/lock/$(basename "$0").lock"
exec 200>"$LOCK_FILE"

if ! flock -n 200; then
echo "Esecuzione precedente ancora attiva, salto questo ciclo" >&2
exit 0
fi

echo "Lock acquisito, avvio il job reale"

... logica dello script ...Il flag -n rende l’acquisizione non bloccante: se un’altra istanza detiene già il lock, lo script esce subito invece di accodarsi. Se preferite attendere fino a un certo timeout invece di saltare il ciclo, -w 30 attende fino a 30 secondi prima di arrendersi. È preferibile salvare il lock file sotto /run/lock piuttosto che /tmp, che su molte distribuzioni viene ripulito periodicamente anche mentre un processo è in esecuzione. In alternativa, il locking si può applicare direttamente dal crontab senza toccare lo script:

*/1 * * * * /usr/bin/flock -n /run/lock/sync.lock /usr/local/bin/sync.sh4. Un watchdog completo, con logica di retryMettendo insieme logging, controllo di stato e gestione ’errore, un caso d’uso ricorrente per un sistemista è un watchdog che verifica un servizio e tenta un riavvio in caso di failure:

#!/usr/bin/env bash
set -euo pipefail

SERVICE="nginx"
LOGFILE="/var/log/watchdog.log"

log() {
echo "[$(date '+%Y-%m-%d %H:%M:%S')] $1" >> "$LOGFILE"
}

if ! systemctl is-active --quiet "$SERVICE"; then
log "$SERVICE risulta down. Tento il riavvio."
systemctl restart "$SERVICE"
if systemctl is-active --quiet "$SERVICE"; then
log "$SERVICE riavviato correttamente."
else
log "$SERVICE non è ripartito: serve intervento manuale."
exit 1
fi
fiNotate l’uso di exit 1 nel caso di fallimento definitivo: se questo script è invocato da un sistema di monitoraggio esterno (Nagios, Zabbix, un semplice controllo su exit code), un codice di uscita diverso da zero è ciò che permette di trasformare un log dimenticato in un alert reale.

Debug: strumenti che risparmiano orebash -n script.sh — verifica solo la sintassi, senza eseguire nulla

bash -x script.sh — traccia ogni comando con le variabili espanse, utile per capire cosa succede realmente riga per riga

set -x / set +x — attiva/disattiva il tracing solo su una porzione dello script

shellcheck script.sh — statica che individua variabili non quotate, condizioni malformate e pipe inutili che bash -n non può rilevare; è disponibile nei repository di tutte le principali distribuzioni ed è ormai lo standard de facto prima di qualsiasi merge in un repository di script di automazione

ConclusioneLe basi della sintassi bash si imparano in un pomeriggio; la differenza tra uno script giocattolo e uno adatto alla produzione sta tutta negli aspetti che spesso vengono aggiunti solo dopo il primo incidente in produzione: modalità strict usata consapevolmente, logging pensato per l’esecuzione non interattiva, locking per evitare sovrapposizioni, e una pipeline minima di verifica (shellcheck più test manuale con bash -x) prima di schedulare qualsiasi cosa su cron o systemd timer. Vale la pena trattare gli script di automazione con lo stesso rigore riservato al codice applicativo: revisione, versionamento e, quando possibile, un minimo di test automatizzati.

Fonte originale: Linux Bash Scripting: Writing Your First Script, LinuxBlog.io.

#linux #programmazione #guide #howto #tutorial #dev

0

Caricamento...

0
2

Caricamento...

Container WSL su Windows: guida a wslc, l’alternativa gratuita a Docker Desktop

Il 29 settembre 2026 Microsoft ha reso generalmente disponibili i , portando su la po

Altro...

Il 29 settembre 2026 Microsoft ha reso generalmente disponibili i , portando su la possibilità di eseguire container nativi senza installare Desktop. La funzionalità arriva con wslc.exe, un nuovo strumento a riga di comando integrato direttamente nel Windows Subsystem for Linux (WSL 3.0.1), e segna un passo importante per chi lavora quotidianamente con container su macchine Windows: sviluppatori .NET, team e sistemisti che gestiscono ambienti ibridi.

In questo articolo vediamo cosa cambia rispetto a Docker Desktop, come installare e usare wslc, quali sono i controlli enterprise disponibili tramite e for Endpoint, e quali limiti bisogna conoscere prima di adottarlo in produzione.

Perché WSL containers e non “solo” Docker DesktopFino ad oggi, eseguire container Linux su Windows significava quasi sempre installare Docker Desktop, che a sua volta si appoggia su una VM WSL2 per fornire il kernel Linux. Con i container WSL, Microsoft sposta il motore dei container direttamente dentro l’infrastruttura WSL, eliminando uno strato intermedio: niente demone Docker separato da gestire, niente licenza Docker Desktop da considerare per le aziende con più di 250 dipendenti o oltre 10 milioni di dollari di fatturato (requisito che per molte realtà italiane ha reso Docker Desktop un costo da giustificare).

Il risultato dichiarato da Microsoft è un accesso ai file Windows fino a 2 volte più veloce rispetto alle soluzioni basate su virtiofs tradizionale, grazie a un nuovo modello di rete chiamato internamente “Consommé mode”, che instrada il traffico della VM attraverso un processo Windows eseguito con i permessi dell’utente della sessione, migliorando la compatibilità con VPN aziendali e firewall perimetrali — uno scenario molto comune nelle reti enterprise italiane dove Docker Desktop spesso va in conflitto con client VPN come Cisco AnyConnect o Fortinet.

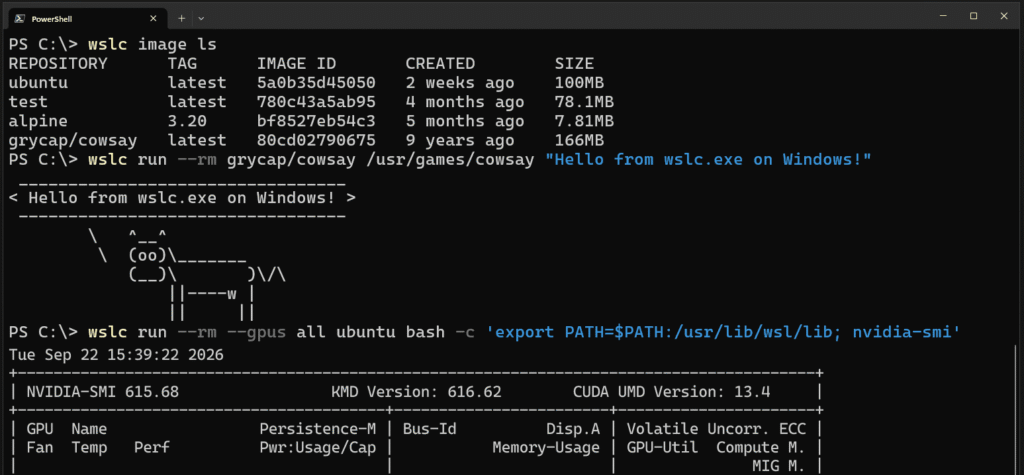
Installazione e primi comandiNon serve installare nulla di separato: wslc.exe è incluso a partire da WSL 3.0.1. Basta aggiornare WSL dal prompt dei comandi o da PowerShell:

wsl --update
wsl --versionIl comando wsl --version deve riportare almeno la 3.x (oppure 2.9.3+ per chi è rimasto sul canale di anteprima). Fatto questo, si può avviare subito un primo container di prova:

wslc run --rm -it ubuntu:latest bash -c "echo Hello world from WSL container!"Per un caso d’uso più realistico, ecco come avviare un web server Nginx in background con il port forwarding verso l’host Windows:

wslc run -it --rm -d -p 8080:80 --name web nginx
curl localhost:8080La gestione del ciclo di vita dei container ricalca la sintassi Docker, cosa che rende la curva di apprendimento quasi nulla per chi già conosce Docker CLI:

wslc container ps
wslc container stop web
wslc container restart web
wslc container cp web:/var/log/nginx/access.log .
wslc system info
wslc eventsCon la GA sono arrivati anche comandi per la gestione della rete, utili quando si orchestrano più container che devono comunicare tra loro:

wslc network create mynet
wslc network connect mynet web
wslc network disconnect mynet webPer le immagini, sono supportati i flag più comuni per operazioni di pull/push ed ispezione:

wslc pull --all-tags myregistry/myimage
wslc image list --all --digests
wslc image inspect --size myregistry/myimageArchitettura: cosa succede sotto il cofanoDal punto di vista architetturale, Microsoft ha separato le responsabilità in due processi distinti:

wslservice.exe crea la macchina virtuale WSL ma non ne mantiene la proprietà operativa dei container;

wslcsession.exe, eseguito a livello utente, gestisce effettivamente i container, il mounting dei volumi e il binding delle porte.

Questa separazione mantiene isolate le operazioni privilegiate dal resto, un dettaglio che conta per chi deve valutare la postura di sicurezza dell’ambiente. Ogni sessione utente ha il proprio disco virtuale dedicato, salvato in %AppData%\Local\wslc\sessions, che contiene immagini, container, reti e volumi di quella sessione. I path Windows vengono montati tramite virtiofs, mentre i filesystem nativi Linux usano volumi basati su VHD per prestazioni migliori.

Supporto GPU e integrazione .NETPer chi sviluppa su Windows con carichi di lavoro che richiedono accelerazione hardware (training di modelli, inferenza locale, elaborazione video), l’accesso alla GPU è esposto tramite il nuovo pacchetto NuGet Microsoft.WSL.Containers, che oltre alla GPU espone anche stdin/stdout, mount di file e configurazione di rete direttamente da codice C#. È un’ottima notizia per i team .NET che vogliono orchestrare container Linux senza uscire dal proprio stack di sviluppo abituale, magari dentro una pipeline di test o un tool interno scritto in C#.

Da notare che il supporto per la projection C++/WinRT è ancora in anteprima e soggetto a breaking change, mentre l’API per sviluppatori C# risulta più stabile e pronta per un uso quotidiano.

Controlli enterprise: Intune e Defender for EndpointPer i reparti IT che devono governare l’adozione di questa tecnologia in azienda, Microsoft ha introdotto due leve di controllo tramite Intune:

Allow WSL containers access: un interruttore on/off per abilitare o disabilitare completamente la funzionalità sui dispositivi gestiti;

WSL containers registry allow list: permette di restringere il pull delle immagini solo ai registry approvati, un controllo fondamentale per evitare che gli utenti scarichino immagini da fonti non verificate.

Sul fronte della sicurezza runtime, il plugin WSL di Microsoft Defender for Endpoint è stato esteso per coprire anche i container, mostrando attività di processo, file e rete collegate all’host Windows. È importante sottolineare che si tratta di visibilità e capacità di indagine, non di un meccanismo di enforcement in tempo reale: Defender segnala e documenta, ma la prevenzione attiva resta affidata alle policy Intune.

I limiti da conoscere prima di migrarePrima di sostituire Docker Desktop in produzione, vale la pena considerare alcuni limiti ancora presenti alla GA:

Nessun supporto Compose: è la funzionalità più richiesta dalla community e il lavoro è iniziato, ma Microsoft non ha ancora comunicato una data di rilascio. Chi ha workflow multi-servizio basati su docker compose up dovrà continuare a usare strumenti alternativi o avviare manualmente i singoli container;

Compatibilità “quasi” totale: test di terze parti riportano buona compatibilità con i comandi Docker esistenti, ma non totale — vale la pena testare gli script di automazione esistenti prima di un rollout su larga scala;

API C++/WinRT instabile: chi sviluppa tooling nativo in C++ dovrà aspettarsi possibili breaking change nelle prossime release.

Conclusione: chi dovrebbe provarlo subitoPer sviluppatori singoli e piccoli team che non dipendono da Docker Compose, i container WSL rappresentano già oggi un’alternativa solida, gratuita e integrata nativamente in Windows, con un vantaggio prestazionale concreto sull’I/O dei file. Per i team che si affidano a Compose nei workflow quotidiani, conviene affiancare wslc agli strumenti attuali e monitorare l’evoluzione del supporto. Per i reparti IT enterprise, il consiglio è di testare i controlli di governance (Intune e Defender) in un gruppo pilota prima di abilitare la funzionalità su larga scala, verificando in particolare il comportamento con le VPN aziendali e i registry Docker privati già in uso.

Fonte: 4sysops.com e WindowsForum

#linux #windows #container #docker #guide #howto #tutorial #wsl

0

Caricamento...

0
1

Caricamento...

WDS e PXE in pensione: la guida completa alla migrazione verso ConfigMgr, UEFI HTTPS Boot e Autopilot

Microsoft ha ufficializzato quello che molti amministratori di sistema temevano da tempo: Deployment

Altro...

Microsoft ha ufficializzato quello che molti amministratori di sistema temevano da tempo: Deployment Services (WDS), insieme al suo motore (Preboot Execution Environment), è stato dichiarato deprecato a partire dalla prossima di Windows Server. Non si tratta di una rimozione immediata — il ruolo resta funzionante su Windows Server 2016, 2019, 2022, 23H2 e 2025 — ma la direzione è chiara, e chi gestisce infrastrutture di imaging bare-metal farebbe bene a iniziare a pianificare la migrazione già ora, prima che la finestra di manovra si riduca.

In questo articolo vediamo cosa cambia esattamente, perché Microsoft ha preso questa decisione, e quali sono le alternative concrete indicate dalla documentazione ufficiale, con relativi pro e contro per chi deve scegliere il percorso di migrazione.

Cosa viene deprecato, nel dettaglioLa deprecazione non riguarda un singolo componente, ma l’intero stack WDS:

Il ruolo server WDS e i suoi componenti Deployment Server / Transport Server

La funzionalità di PXE boot e network bootstrap fornita da WDS

Gli strumenti di gestione, le CLI (wdsutil), le API e i percorsi di attivazione del servizio

Il trasporto multicast e i flussi di deployment che ne dipendono

I componenti WinPE-WDS-Tools usati per costruire immagini di boot personalizzate

Non è una novità improvvisa: già nel 2021 Microsoft aveva deprecato i flussi di boot.wim basati su WDS per Windows 11 e versioni successive, e ad aprile 2026 gli scenari di deployment “hands-free” tramite WDS sono stati disabilitati di default nelle installazioni più recenti. La deprecazione formale del ruolo server è quindi l’ultimo tassello di un percorso iniziato da anni.

Perché ora?WDS si appoggia su un’architettura di rete e boot (BIOS/PXE legacy, multicast, protocolli TFTP non cifrati) che non si allinea più con i requisiti di sicurezza moderni: niente autenticazione del client prima del trasferimento dell’immagine, nessuna cifratura del traffico di boot, e una superficie di attacco che include il classico problema del “server DHCP/PXE non autorizzato in rete”. Con l’adozione crescente di UEFI Secure Boot, TPM 2.0 e gestione -first dei dispositivi, mantenere un componente legacy come WDS come via principale di provisioning ha sempre meno senso per Microsoft.

Le alternative raccomandate1. Configuration Manager PXE responder (senza WDS)È l’alternativa che Microsoft raccomanda in modo più esplicito per chi già (o può adottare) Microsoft Configuration Manager (ConfigMgr/MECM). Il PXE responder di ConfigMgr può funzionare in modalità standalone, senza dipendere dal ruolo WDS sottostante, gestendo direttamente le richieste di boot di rete. La distribuzione del sistema operativo tramite ConfigMgr (task sequence, immagini, driver package) resta una capacità pienamente supportata e non deprecata: cambia solo il livello di trasporto della fase di boot iniziale.

Per chi ha già un’infrastruttura ConfigMgr consolidata, questa è generalmente la strada a minor attrito: la migrazione richiede di riconfigurare il ruolo di distribuzione point per gestire il PXE senza il servizio WDS legacy sottostante, verificando compatibilità di firmware e switch di rete (in particolare per IP helper/DHCP relay).

  1. Soluzioni PXE di terze partiEsistono implementazioni PXE non Microsoft, sia commerciali sia open source, che restano ovviamente non toccate dalla deprecazione. Tra le più note in ambito /eterogeneo:

Esempio: avvio di un server PXE minimale con dnsmasq su Linux

sudo apt install dnsmasq
cat <<EOF > /etc/dnsmasq.d/pxe.conf
interface=eth0
dhcp-range=192.168.10.100,192.168.10.200,12h
dhcp-boot=pxelinux.0
enable-tftp
tftp-root=/srv/tftp
EOF
sudo systemctl restart dnsmasqSoluzioni come netboot.xyz, iPXE o piattaforme MDM/deployment di terze parti offrono spesso funzionalità più moderne (boot via HTTP/HTTPS, script di boot dinamici, interfacce ) rispetto al vecchio WDS, ma richiedono comunque un progetto di migrazione: mappatura delle immagini esistenti, retraining del personale, e in alcuni casi costi di licenza.

  1. UEFI HTTP(S) BootPer i dispositivi con firmware UEFI moderno, il boot via HTTP(S) è un’alternativa nativa al PXE tradizionale, con il vantaggio di poter cifrare il trasferimento dell’immagine di boot. Microsoft è però esplicita nel dire che non è un sostituto diretto del PXE responder di ConfigMgr: si tratta di un meccanismo di trasporto complementare, utile in scenari specifici (ad esempio boot attraverso reti che non supportano bene il multicast/broadcast PXE), ma che da solo non copre tutte le funzionalità di un flusso di OS deployment completo.

  2. Windows Autopilot per i nuovi dispositiviPer chi acquista hardware nuovo, Microsoft continua a spingere verso Windows Autopilot: il provisioning avviene “out of the box”, senza immagine personalizzata da distribuire via rete, con il dispositivo che si registra e si configura da cloud (Entra ID/Intune) al primo avvio. Non è un rimpiazzo 1:1 di WDS per il re-imaging di parco macchine esistente, ma per il ciclo di vita dei nuovi PC riduce drasticamente (o azzera) la necessità di un’infrastruttura PXE.

Come pianificare la migrazionePrima di scegliere una strada, la documentazione Microsoft raccomanda alcuni passi di analisi che vale la pena seguire alla lettera:

Censire tutte le implementazioni WDS attive nell’organizzazione, comprese quelle “nascoste” in filiali o laboratori

Verificare le dipendenze da Configuration Manager, immagini WinPE personalizzate e utilizzo di wdsutil in script di automazione

Valutare l’impatto sulla capacità di deployment unicast se oggi si fa affidamento sul multicast di WDS per grandi rollout simultanei

Validare le alternative in condizioni realistiche di rete e firmware, non solo in laboratorio: switch, VLAN, IP helper e compatibilità UEFI vanno testati sul campo

Per organizzazioni di medie e grandi dimensioni, la combinazione più pragmatica nel breve-medio termine è spesso: ConfigMgr PXE responder per il parco macchine esistente da re-immaginare, e Windows Autopilot per tutto l’hardware di nuovo acquisto. Le soluzioni di terze parti restano un’opzione valida soprattutto per ambienti eterogenei Linux/Windows che già non dipendevano fortemente da WDS.

ConclusioneNon c’è ancora una data di rimozione definitiva per WDS, ma il messaggio di Microsoft è inequivocabile: è il momento di uscire dalla comfort zone del vecchio PXE responder integrato in Windows Server. Chi gestisce infrastrutture di imaging dovrebbe iniziare subito il censimento delle dipendenze e un piccolo pilot su una delle alternative disponibili, per evitare di trovarsi a rincorrere la migrazione quando il supporto verrà effettivamente ritirato.

Fonte: Microsoft Support e 4sysops

#windows #guide #howto #tutorial #pxe #windowsserver

0

Caricamento...

0
1

Caricamento...

Addio SMS e voce per l’MFA in Entra ID: la guida completa alla migrazione verso i passkey

Microsoft ha fissato una scadenza precisa per uno dei metodi di autenticazione più diffusi e più deboli in Mi

Altro...

Microsoft ha fissato una scadenza precisa per uno dei metodi di autenticazione più diffusi e più deboli in Microsoft ID: SMS e chiamata vocale come secondo fattore stanno per essere ritirati. Non si tratta di una deprecazione generica “prima o poi”, ma di un piano con date certe, comportamenti di enforcement automatici e un percorso di migrazione verso i passkey che ogni amministratore Entra dovrebbe pianificare già da ora, prima che sia il sistema a farlo al posto suo.

Perché SMS e voce vengono ritiratiLa motivazione tecnica è nota da anni: SMS e chiamate vocali come fattore di autenticazione sono vulnerabili a SIM swapping, intercettazione tramite SS7, in tempo reale e engineering verso gli operatori telefonici. Microsoft li classifica ormai come metodi “non phishing-resistant” e punta decisamente su passkey (FIDO2), Hello for Business e chiavi di sicurezza hardware come standard per l’ in azienda.

La differenza rispetto ad annunci precedenti è che questa volta il ritiro non è opzionale: è accompagnato da un’attivazione automatica dei passkey per gli utenti coinvolti e da un enforcement che, superata la data limite, blocca l’accesso finché l’utente non registra un metodo alternativo.

Le date da segnare in calendarioDataEventoPopolazione interessata1 settembre 2026Attivazione automatica dei passkey e avvio delle campagne di registrazioneTutti gli utenti abilitati a SMS/voce1 febbraio 2027Ritiro di SMS e voce forniti da MicrosoftUtenti standard e guest interniDopo il 1 febbraio 2027Prompt di registrazione passkey bloccante al loginUtenti il cui unico metodo MFA era SMS/voce1 luglio 2027Ritiro di SMS e voceGlobal Administrator e utenti esterni (guest B2B)Dal 30 ottobre 2026Disponibilità di provider telecom gestiti dal cliente via Microsoft Security StoreOrganizzazioni con esigenze regolamentari specificheDa notare un dettaglio spesso frainteso: gli utenti guest interni al tenant seguono la scadenza di febbraio 2027, non quella estesa di luglio riservata a Global Administrator e utenti esterni B2B.

Cosa succede a chi non migra in tempoNon c’è un blocco account improvviso, ma qualcosa di funzionalmente equivalente per chi dipende solo da SMS o voce: al primo accesso dopo la data di ritiro applicabile, l’utente riceve un prompt di registrazione passkey bloccante, che non può essere posticipato o saltato. Senza completare la registrazione, l’accesso all’account resta sospeso. Non è previsto alcun periodo di grazia dopo l’enforcement, quindi la finestra utile per agire è quella prima delle date sopra indicate.

Come censire gli utenti a rischioPrima di lanciare qualsiasi campagna di comunicazione, serve sapere quanti e quali utenti dipendono oggi da SMS/voce. Microsoft ha pubblicato uno script dedicato sul repository GitHub microsoft/entra-sms-voice-usage-analyzer, pensato proprio per questo censimento. Per eseguirlo servono ruoli con permessi di lettura sufficienti:

Global Reader

Authentication Policy Administrator

Security Reader

Qualunque risultato diverso da zero indica utenti che rientrano nel perimetro della migrazione e vanno inseriti in una campagna di registrazione mirata.

Attivare la campagna di registrazione passkeyPer anticipare l’attivazione automatica del 1 settembre 2026 e gestirla in modo controllato, è possibile configurare da subito una Registration Campaign dedicata:

Accedere al Microsoft Entra admin center con un account Authentication Policy Administrator

Navigare su Entra ID > Authentication methods > Registration campaign

Impostare lo State su Microsoft Managed

Puntare la campagna sul gruppo di sicurezza contenente gli utenti SMS/voce individuati con lo script

In alternativa, chi ha bisogno di più tempo prima che i passkey vengano abilitati automaticamente può temporaneamente disattivare l’enrollment automatico via Microsoft Graph, con permesso Policy.ReadWrite.AuthenticationMethod:

PATCH https://graph.microsoft.com/beta/policies/authenticationmethodspolicy
Content-Type: application/json

{
"optOutSettings": {
"passkeyDynamicMigration": true
}
}È importante essere chiari su cosa fa davvero questa impostazione: ritarda l’attivazione automatica dei passkey e della registration campaign tra il 1 settembre 2026 e il 1 febbraio 2027, ma non esonera dall’obbligo di migrazione entro le scadenze di enforcement. Gli utenti dovranno comunque completare la registrazione entro il 1 febbraio o il 1 luglio 2027 a seconda del profilo.

Tipologie di passkey supportateEntra ID distingue due famiglie di passkey, con implicazioni diverse in termini di portabilità e superficie di attacco:

Passkey sincronizzati: memorizzati nel credential manager della piattaforma (iCloud Keychain, Google Password Manager) e sincronizzati automaticamente tra i dispositivi dell’utente

Passkey device-bound: vincolati a un singolo dispositivo o dispositivo hardware, come una chiave di sicurezza FIDO2, il passkey in Microsoft Authenticator o l’Entra Passkey su Windows

Per gli scenari con requisiti di sicurezza più stringenti (accessi privilegiati, Global Administrator, ambienti regolamentati), i passkey device-bound su hardware dedicato restano la scelta più solida, in linea con i principi delle Conditional Access authentication strengths già usati per imporre metodi phishing-resistant sui ruoli critici.

E chi ha davvero bisogno di SMS per motivi regolamentari?Microsoft non lascia completamente scoperto questo scenario: a partire dal 30 ottobre 2026 sarà possibile configurare un provider telecom gestito dal cliente tramite il Microsoft Security Store, con un modello di costo a consumo (in genere per messaggio, variabile per provider e area geografica). È un’opzione pensata per casi specifici e documentati, non per prorogare la migrazione in generale: vale la pena valutarla solo dopo aver verificato un’effettiva necessità operativa o normativa, con un pilot prima del rollout su larga scala.

Un piano di comunicazione in tre passaggiLa parte tecnica è la metà del lavoro; l’altra metà è evitare un’ondata di ticket all’help desk nelle settimane a ridosso delle scadenze. Un approccio che funziona bene su tenant di medie e grandi dimensioni:

Awareness: comunicare per tempo il ritiro e i vantaggi dei passkey (accesso più rapido, resistenza al phishing, niente più codici da copiare)

Azione: fornire istruzioni specifiche per piattaforma (Windows Hello, iOS, Android, chiavi FIDO2) e un link diretto alla registrazione

Promemoria mirati: usare i dati di registrazione per contattare solo gli utenti ancora non conformi, non l’intero tenant

Microsoft mette a disposizione modelli di comunicazione già pronti (email, Teams, portali) che riducono sensibilmente il lavoro di scrittura per i team IT.

ConclusioneIl ritiro di SMS e voce in Entra ID segna, di fatto, la fine dell’MFA “debole” come opzione di default nell’ecosistema Microsoft. Per chi amministra tenant Entra ID, la finestra utile per una migrazione ordinata è già aperta: censire gli utenti, attivare una registration campaign controllata, comunicare con anticipo e testare i passkey sui ruoli privilegiati prima che sia l’enforcement automatico, il 1 febbraio o il 1 luglio 2027, a farlo in modo brusco e bloccante.

Fonte: Petri IT Knowledgebase, con approfondimento dalla documentazione ufficiale Microsoft Learn.
#sicurezza #microsoft #guide #entra #azure #mfa

0

Caricamento...

0
1

Caricamento...

Java 27: G1 diventa il garbage collector di default ovunque, debutta il TLS post-quantistico ibrido

Java 27 è arrivato, e cambia due default che riguardano tuttiIl 15 settembre 2026 Oracle ha rilasciato 27 (JDK 27), la nuova a cadenza

Altro...

Java 27 è arrivato, e cambia due default che riguardano tuttiIl 15 settembre 2026 Oracle ha rilasciato 27 (JDK 27), la nuova a cadenza semestrale del linguaggio. Come spesso accade con le versioni “dispari” del ciclo a sei mesi, non è la release con il maggior numero di feature preview eclatanti, ma introduce due cambiamenti strutturali che meritano attenzione da parte di chi gestisce applicazioni Java in produzione: il garbage collector G1 diventa il default in ogni ambiente, e arriva il supporto nativo a scambi di chiavi TLS 1.3 resistenti al calcolo quantistico. Sono esattamente il tipo di cambiamenti “silenziosi” che possono modificare il comportamento di un’applicazione senza che una sola riga di codice venga toccata.

JEP 523: G1 diventa il garbage collector di default ovunqueDa JDK 9, G1 (Garbage-First) è il collector di default negli ambienti “server”, mentre le JVM avviate in configurazioni più leggere o vincolate in termini di risorse ricadevano sul Serial Collector, storicamente più economico in termini di footprint di memoria e tempo di avvio ma limitato a un singolo thread di collezione.

Con JEP 523, questa distinzione sparisce: G1 diventa il default in tutti gli ambienti, incluse le configurazioni precedentemente riservate a Serial. La motivazione tecnica dichiarata dal team OpenJDK è che il lavoro di ottimizzazione degli ultimi anni ha reso G1 “competitivo con Serial a qualsiasi dimensione di heap”, con throughput, latenza, footprint di memoria e tempo di startup comparabili anche sui carichi più piccoli — lo scenario in cui Serial aveva storicamente il vantaggio più netto.

Per chi amministra JVM in produzione, questo significa in pratica:

Se non specificate esplicitamente un collector con -XX:+UseSerialGC, -XX:+UseParallelGC o -XX:+UseZGC, dopo l’upgrade a Java 27 la vostra applicazione userà G1 anche in scenari dove prima girava su Serial — ad esempio con limiti di memoria molto stretti o con heap ridotti.

G1 introduce collezione a più thread e fasi concorrenti che Serial non ha: aspettatevi un pattern di utilizzo leggermente diverso durante i cicli di garbage collection, specialmente su ambienti con pochi core disponibili.

Se avete pipeline di test delle o SLA di latenza stretti su servizi con footprint minimo (ad esempio funzioni serverless o batch job short-lived), vale la pena ripetere un benchmark mirato prima di fare l’upgrade in produzione, anche se il team OpenJDK dichiara di non aver osservato regressioni significative.

Per tornare al comportamento precedente è sufficiente il flag esplicito -XX:+UseSerialGC in fase di avvio della JVM: nessuna riscrittura di codice necessaria.

Va inoltre ricordato che da JDK 24 le Compact Object Headers (JEP 450, poi consolidate) sono considerate stabili e restano attive di default anche in Java 27: l’header degli oggetti passa da 96 a 64 bit su architetture a 64 bit, con benefici diretti su densità di deployment, località dei dati in cache e footprint complessivo dell’heap. Combinato con G1 come default universale, il risultato netto è una JVM pensata per comportarsi in modo più uniforme sia su un server con centinaia di GB di heap sia su un container con 256 MB di limite.

JEP 527: scambio di chiavi TLS 1.3 ibrido e resistente al quantum computingLa seconda novità di rilievo riguarda la sicurezza delle comunicazioni. JEP 527 introduce nelle API javax.net.ssl il supporto a schemi di scambio di chiavi ibridi per TLS 1.3, che combinano un algoritmo classico basato su curve ellittiche con un algoritmo post-quantistico basato su reticoli (ML-KEM, standardizzato da NIST).

La motivazione non è ipotetica: il problema noto come “harvest now, decrypt later” descrive una minaccia già attuale, in cui traffico cifrato oggi con algoritmi classici viene intercettato e archiviato da attori con risorse importanti, in attesa che un futuro computer quantistico sufficientemente potente permetta di decifrarlo retroattivamente. Per dati con un valore di confidenzialità che si estende su anni — cartelle cliniche, segreti industriali, comunicazioni governative — agire ora, prima che il quantum computing su scala sia disponibile, è l’unica strategia sensata.

Uno schema ibrido ha una proprietà rassicurante per chi deve fidarsi della oggi: rimane sicuro finché almeno uno dei due algoritmi componenti resiste, offrendo quindi il meglio di entrambi i mondi senza scommettere tutto sulla novità.

I tre gruppi supportatiJEP 527 introduce tre nuovi “named group” per TLS 1.3, ciascuno combinazione di ECDHE classico e ML-KEM:

X25519MLKEM768 — Curve25519 + ML-KEM-768

SecP256r1MLKEM768 — curva secp256r1 + ML-KEM-768

SecP384r1MLKEM1024 — curva secp384r1 + ML-KEM-1024, il livello di sicurezza più alto

L’ordine di preferenza di default della JVM diventa: X25519MLKEM768, x25519, secp256r1, secp384r1, secp521r1, x448, ffdhe2048, ffdhe3072, ffdhe4096, ffdhe6144, ffdhe8192. In altre parole, X25519MLKEM768 ha la priorità più alta: se sia client che server supportano TLS 1.3 su Java 27 senza configurazioni personalizzate, lo scambio di chiavi ibrido post-quantistico viene negoziato automaticamente, senza alcuna modifica al codice applicativo.

Come controllare o disabilitare il comportamentoChi ha bisogno di un controllo più fine — ad esempio per motivi di compatibilità con sistemi legacy o per test di interoperabilità — può intervenire in due modi.

Via system property, per sovrascrivere globalmente l’elenco dei gruppi supportati:

-Djdk.tls.namedGroups="secp256r1,x25519"Oppure programmaticamente, tramite SSLParameters, per un controllo puntuale sulla singola connessione:

SSLSocket tlsSock = (SSLSocket)(SSLContext.getDefault().
getSocketFactory().createSocket());
SSLParameters params = tlsSock.getSSLParameters();
params.setNamedGroups(new String[] {
"SecP256r1MLKEM768", "X25519MLKEM768", "secp256r1", "x25519"
});
tlsSock.setSSLParameters(params);Un punto operativo da non sottovalutare: i messaggi TLS ClientHello che negoziano questi gruppi ibridi sono più grandi rispetto a quelli con solo curve ellittiche classiche, per via delle chiavi pubbliche ML-KEM più voluminose. Se avete middlebox, load balancer o proxy TLS datati che fanno parsing rigido dei pacchetti ClientHello, vale la pena verificarne il comportamento prima del rollout su larga scala — è un problema già osservato in altri ecosistemi (, OpenSSH) nella fase di adozione del PQC ibrido.

Altre novità degne di notaJEP 533 — Structured Concurrency (settima preview): il modello che tratta gruppi di task correlati eseguiti su thread diversi come un’unica unità di lavoro continua la sua maturazione, riducendo i rischi di thread leak e semplificando cancellazione e gestione degli errori nei flussi concorrenti. Resta in preview, quindi da usare con il flag --enable-preview e non ancora adatta a codice di produzione stabile.

JEP 532 — Primitive Types in Patterns (quinta preview): estende il pattern matching ai tipi primitivi, avvicinando ulteriormente la maturazione di questa funzionalità.

JEP 537 — Vector API (dodicesimo incubator): continua il lungo percorso di incubazione delle API vettoriali per carichi di data analytics e inferenza AI, pensate per sfruttare le istruzioni SIMD della CPU.

Cosa significa per chi pianifica un upgradeNessuna delle due novità principali richiede modifiche al codice applicativo, ma entrambe cambiano comportamenti impliciti su cui molti team non hanno mai dovuto ragionare esplicitamente. Prima di un upgrade a Java 27 in produzione, ha senso:

Verificare quale garbage collector state effettivamente usando oggi (spesso implicito, mai impostato esplicitamente) e ripetere un test di carico rappresentativo dopo l’upgrade, specialmente su servizi con heap piccoli o vincoli di latenza stretti.

Testare l’interoperabilità TLS con eventuali componenti di rete intermedi (load balancer, WAF, proxy) prima di esporre servizi che useranno automaticamente lo scambio di chiavi ibrido.

Se la vostra organizzazione ha requisiti di conformità legati alla crittografia post-quantistica (settore finanziario, sanitario, pubblica amministrazione), Java 27 offre finalmente un percorso “out of the box” senza dover ricorrere a provider crittografici di terze parti.

Nel complesso, Java 27 conferma una tendenza già vista in altri runtime e protocolli (OpenSSH, i principali browser): la crittografia post-quantistica sta passando rapidamente da tema di ricerca a default silenzioso nelle piattaforme che usiamo ogni giorno. Vale la pena arrivarci preparati, piuttosto che scoprirlo il giorno dell’upgrade.

Fonte: Oracle Java Blog – The Arrival of Java 27, con approfondimenti da Phoronix e dalle specifiche ufficiali JEP 523 e JEP 527 su OpenJDK.org.

#sicurezza #programmazione #guide #howto #dev #java

1

Caricamento...

0
2

Caricamento...

La finestra di patching si sta chiudendo: perché il vecchio modello non basta più

Il problema non è più “quando” applicare le patch, ma “quanto” siamo espostiPer anni la gestione delle nelle infrastrutture IT ha seguito una l

Altro...

Il problema non è più “quando” applicare le patch, ma “quanto” siamo espostiPer anni la gestione delle nelle infrastrutture IT ha seguito una logica prudente: rilasciare l’aggiornamento, aspettare qualche giorno o settimana per verificare che non rompa nulla in produzione, poi distribuirlo in ondate controllate. Questo modello, ragionevole quando gli attaccanti impiegavano settimane a sviluppare un exploit funzionante, sta diventando insostenibile di fronte a una realtà cambiata radicalmente: gli attori malevoli usano oggi strumenti di intelligenza artificiale per identificare e sfruttare le vulnerabilità in tempi drasticamente più brevi rispetto ai cicli di patching tradizionali.

Il punto non è più teorico. Il volume di vulnerabilità pubblicate mensilmente ha raggiunto livelli che nessun team può gestire con processi manuali: nel Patch Tuesday di giugno 2026 Microsoft ha corretto 208 vulnerabilità, salite a 621 in luglio, di cui 63 classificate come critiche e almeno 2 già sfruttate attivamente al momento del rilascio. Nessun tecnico può ragionevolmente assorbire quel volume come uno dei tanti task settimanali, e infatti le linee guida Microsoft più recenti raccomandano finestre di differimento inferiori a tre giorni per gli aggiornamenti qualitativi, con deadline di installazione a zero o un giorno e non più di due giorni di margine.

Da “patch dei computer” a “gestione del ciclo di vita di tutto ciò che è connesso”Il cambio di paradigma proposto non è semplicemente “patchare più in fretta”, ma ripensare cosa significhi effettivamente gestire il rischio di un parco IT. Il modello classico, incentrato sull’endpoint patching, lascia scoperta una superficie di attacco enorme e in crescita: stampanti di rete, telecamere IP, sistemi HVAC, telefoni VoIP, PLC industriali. Sono tutti dispositivi connessi alla rete aziendale, spesso raggiungibili da , quasi mai coperti dai sistemi di patch management tradizionali e, in molti casi, privi di un meccanismo di aggiornamento comodo o di supporto attivo del vendor.

Il risultato è una classe intera di apparati “connessi, esposti e ignorati” — per usare la formula più efficace del problema — che rappresentano oggi un vettore di compromissione tanto concreto quanto un server non aggiornato, ma con una probabilità molto più bassa di rientrare in un audit di sicurezza periodico.

Un caso reale: PLC industriali sotto attaccoNon è uno scenario ipotetico. Nel corso del 2026 un avviso del governo statunitense ha documentato attori legati all’Iran nell’atto di sfruttare controllori logici programmabili (PLC) esposti direttamente su Internet in infrastrutture critiche di settori governativo, idrico, delle acque reflue ed energetico. Gli attaccanti hanno manipolato i file di progetto dei PLC e alterato le visualizzazioni SCADA, causando interruzioni operative e perdite economiche dirette.

Le raccomandazioni pubblicate da CISA in seguito a questi incidenti non riguardavano tecniche sofisticate di difesa, ma fondamentali di sicurezza rimasti clamorosamente disattesi: rimuovere l’esposizione diretta a Internet dei dispositivi, cambiare le credenziali di default, usare complesse, applicare le patch fornite dai vendor quando disponibili. È la controprova di quanto il problema non sia (solo) tecnologico, ma di processo e visibilità.

Cosa cambia in pratica per un team infrastrutturaleTradurre questo cambio di prospettiva in azioni concrete significa lavorare su più fronti contemporaneamente, senza aspettare che sia un incidente a imporre le priorità.

  1. Automazione del patching Windows guidata da policyIl primo passo è tecnicamente il più semplice: abbandonare il rollout scaglionato basato solo sulla prudenza a favore di processi automatizzati e guidati da policy documentate, con eccezioni esplicite e motivate anziché ritardi impliciti “per abitudine”. Strumenti come Windows Update for Business, o WSUS permettono già oggi di configurare deadline aggressive con anelli di sicurezza (rollback automatico, Known Issue Rollback) per i casi in cui un aggiornamento causi regressioni.

  2. Inventario di tutto ciò che è connesso, non solo degli endpoint gestitiServe un censimento che vada oltre l’inventario classico di Active Directory o dell’MDM: switch, access point, stampanti di rete, telecamere, sistemi di building automation, dispositivi OT. Molti di questi asset sono scoperti solo tramite scansione attiva della rete o strumenti di asset discovery dedicati, perché non compaiono mai in un dominio Windows.

  3. Segmentazione di rete per i sistemi non aggiornabiliPer i dispositivi privi di un percorso di patching realistico — firmware non più supportato, hardware embedded, sistemi legacy critici che non possono essere sostituiti a breve — la mitigazione primaria diventa il contenimento: segmentazione di rete dedicata, accesso solo tramite gateway controllati, credenziali univoche e non condivise, monitoraggio del traffico in ingresso/uscita da quei segmenti.

  4. Pianificazione della sostituzione, non solo della protezionePer gli apparati che restano permanentemente non aggiornabili, la sola segmentazione è un palliativo, non una soluzione. Va costruito un piano di sostituzione con priorità basata su esposizione e criticità, invece di lasciare che questi dispositivi restino operativi a tempo indeterminato “perché funzionano ancora”.

Il messaggio di fondo per chi gestisce infrastrutture nel 2026La sintesi più utile di questo cambiamento è che la vecchia domanda — “possiamo aspettare qualche giorno prima di installare questa patch?” — va sostituita da una diversa: “quanto tempo restiamo esposti se aspettiamo, e chi altro nella rete è esposto insieme a noi anche se non lo stiamo patchando direttamente?”. In un contesto in cui gli attaccanti automatizzano la ricognizione e lo sfruttamento delle vulnerabilità con strumenti AI, il differimento smette di essere una misura prudente di default e diventa esso stesso un rischio da giustificare, caso per caso, con un’eccezione documentata.

Per i team più piccoli, senza le risorse di un SOC dedicato, il punto di partenza realistico resta comunque il più efficace: un inventario onesto di tutto ciò che è connesso alla rete, anche (soprattutto) ciò che nessuno ha mai pensato di considerare un “endpoint” da patchare.

Fonte: 4sysops – The patch window is collapsing: why security needs a new control plane e Petri IT Knowledgebase – The Patch Window Is Collapsing. Your Service Model Has to Change, di Amy Babinchak.

#sicurezza #guide #howto #tutorial

0

Caricamento...

0
1

Caricamento...

Load average alle stelle, CPU inattiva: la guida completa alla diagnosi dell’I/O wait su Linux

Il sintomo che inganna: load average alto, CPU quasi fermaCapita spesso a chi gestisce server in produzione: il monitoraggio segnala un load av

Altro...

Il sintomo che inganna: load average alto, CPU quasi fermaCapita spesso a chi gestisce server in produzione: il monitoraggio segnala un load average sopra 30 su una macchina con 24 core, gli utenti si lamentano di risposte lente, ma top mostra la idle al 70%. Il riflesso istintivo è cercare il processo che “mangia CPU”, ma qui il colpevole non c’è da nessuna parte nella lista dei consumi di calcolo: il collo di bottiglia è l’I/O su disco, e la differenza tra i due scenari cambia completamente la strategia di intervento.

Il load average di Linux non misura solo i processi che vogliono la CPU: conta anche quelli bloccati in stato D (uninterruptible sleep), cioè in attesa che il completi un’operazione di I/O. Un load di 30 con CPU libera significa quasi sempre che decine di thread sono in coda per il disco, non per il processore. Diagnosticare questo scenario richiede un metodo diverso da quello usato per un semplice sovraccarico di calcolo, e la differenza si vede negli strumenti da usare e nell’ordine in cui usarli.

Il metro di misura: I/O wait e perché da solo non bastaL’I/O wait (colonna wa in top) è la percentuale di tempo in cui la CPU è rimasta inattiva pur avendo almeno una richiesta di I/O ancora in sospeso. È un indicatore utile ma ingannevole: se il sistema ha altro lavoro da eseguire mentre il disco è lento, la CPU si tiene occupata e il valore di wa scende, anche se lo storage sottostante continua a rispondere altrettanto male. Per questo motivo l’I/O wait va sempre incrociato con metriche a livello di dispositivo, non usato come unico segnale.

Il flusso diagnostico corretto segue quattro passaggi in sequenza:

Controllare load average e colonna wa in top (premendo 1 per espandere le statistiche per singolo core)

Confermare il sospetto a livello di dispositivo con iostat -xz 1 o /proc/pressure/io

Solo a questo punto, andare a caccia dei processi responsabili con atop e iotop

Misurare in modo oggettivo con un benchmark reale (dd o fio), perché un numero concreto chiude ogni discussione

Passo 1 — Individuare i processi bloccatiPrima di aprire strumenti dedicati, un controllo rapido dei processi in stato “uninterruptible sleep” dà già un’indicazione:

ps -eo state,pid,comm | grep "^D"Se questo comando restituisce più righe, ripetutamente, su un sistema che dovrebbe essere reattivo, l’ipotesi I/O-bound si rafforza. Il passo successivo è capire quanto è grave la situazione a livello di dispositivo di blocco.

Passo 2 — iostat: la vista a livello di dispositivoiostat -xz 1I flag hanno un significato preciso:

-x: statistiche estese, incluse le latenze medie di lettura e scrittura

-z: nasconde i dispositivi inattivi, per non affollare l’output con righe a zero

1: intervallo di refresh in secondi

Le colonne da guardare con attenzione sono r_await e w_await, che esprimono in millisecondi il tempo medio di attesa per operazione di lettura e scrittura: su storage sano questi valori restano a una cifra; valori a due o tre cifre indicano un disco sotto stress severo. La colonna %util va invece presa con cautela sui dispositivi SSD/NVMe, dove può risultare fuorviante a causa del parallelismo interno dei controller moderni, che gestiscono più richieste contemporaneamente senza che questo si traduca in saturazione reale.

Un dettaglio pratico spesso ignorato: il primo report stampato da iostat va scartato, perché media tutte le statistiche dall’avvio del sistema e può “truccare” in positivo un disco che in realtà ha iniziato a comportarsi male solo poche ore prima.

Passo 3 — Pressure Stall Information: la metrica più modernaDai kernel 4.20 in poi è disponibile un meccanismo più sofisticato dell’I/O wait tradizionale: la Pressure Stall Information (PSI), esposta in /proc/pressure/io:

cat /proc/pressure/ioUn output tipico in condizioni di forte stress si presenta così:

some avg10=44.21 avg60=39.07 avg300=31.88 total=8814592211
full avg10=38.90 avg60=35.62 avg300=29.15 total=7913804412La riga some indica la percentuale di tempo in cui almeno un task era bloccato in attesa di I/O; la riga full indica la percentuale di tempo in cui tutti i task non idle erano bloccati contemporaneamente — un segnale molto più grave, perché significa che l’intero sistema è fermo in attesa dello storage. Su alcune distribuzioni PSI richiede il parametro di avvio del kernel psi=1 per essere attivo; vale la pena verificarlo prima di fare affidamento su questi dati in produzione.

Passo 4 — Trovare il colpevole con atop e iotopUna volta confermato che il collo di bottiglia è reale a livello di dispositivo, resta da capire quale processo lo sta generando.

atop mostra le statistiche di I/O per disco direttamente nella vista principale; premendo d durante l’esecuzione si passa alla vista dedicata ai processi che stanno consumando I/O. È utile anche per individuare thread kernel come flush-8:0 (il thread di writeback che scarica su disco le pagine sporche dalla cache) o jbd2/sda5-8 (il journaling di ext4), che spesso vengono scambiati per processi “misteriosi” da chi non li conosce.

iotop offre una vista più mirata:

iotop -oPa-o (--only): mostra solo i processi che stanno effettivamente generando I/O in quel momento

-P (--processes): aggrega per processo invece di elencare ogni singolo thread

-a (--accumulated): mostra il totale di I/O accumulato dall’avvio dello strumento, utile per individuare pattern intermittenti

Un requisito spesso trascurato: dal kernel 5.14 il delay accounting è disabilitato di default, e senza di esso iotop non riesce a calcolare correttamente le statistiche per processo. Va abilitato con:

sudo sysctl kernel.task_delayacct=1Per renderlo persistente ai riavvi è necessario aggiungere delayacct ai parametri di boot del kernel (tramite GRUB), oltre a impostare il sysctl in /etc/sysctl.d/.

Chiudere la discussione con un numero: dd e fioQuando la diagnosi è fatta, spesso serve convincere qualcun altro (un cliente, un team infrastrutturale, un fornitore di storage) che il problema è reale. Un test rapido e riproducibile con dd:

dd if=/dev/zero of=diskbench bs=1M count=1024 conv=fdatasyncIl flag conv=fdatasync è essenziale: forza la sincronizzazione dei dati su disco prima che dd riporti il tempo trascorso, altrimenti si misurerebbe solo la velocità della cache di scrittura del kernel. Un risultato come “1073741824 bytes (1.1 GB) copiati, 46.0156 s, 23.3 MB/s” su uno storage che dovrebbe erogare centinaia di MB/s parla da solo, ed è molto più difficile da contestare di un’opinione: un host può discutere con la vostra opinione, molto più difficilmente lo farà con 23,3 MB/s misurati.

Per un quadro più completo, che tenga conto anche di IOPS e latenza sotto carico concorrente (lo scenario tipico di un database o di un server sotto traffico reale), lo strumento di riferimento è fio, che permette di simulare pattern di accesso realistici con più job paralleli, dimensioni di blocco configurabili e miscele di letture/scritture.

Il caso reale: quando il disco lento innesca un effetto dominoUn caso concreto che vale la pena analizzare riguarda un server con un’istanza MySQL configurata con max_connections=2000, un valore decisamente eccessivo per l’hardware disponibile. Ogni connessione MySQL alloca buffer per-thread; moltiplicando la memoria per singolo thread per il numero massimo di connessioni e sommando i buffer globali, il calcolo della memoria potenzialmente necessaria superava ampiamente la RAM installata.

Finché il traffico restava basso, il problema non si manifestava. Ma con un disco già lento (a causa di I/O wait elevato) e un picco di connessioni concorrenti, le richieste si sono accumulate in coda, la pressione di memoria è salita rapidamente, e l’OOM killer del kernel è intervenuto terminando processi critici. Un problema di storage, in altre parole, si è propagato fino a diventare un incidente di memoria e disponibilità.

Buone pratiche per prevenire il problemaAlcune misure pratiche riducono sensibilmente il rischio di trovarsi in questa situazione:

Ridurre la frequenza di scrittura dei log di /Apache in scenari ad alto traffico, dove i log di accesso possono generare un volume di I/O sorprendentemente alto

Spostare la cache in memoria (ad esempio su tmpfs) invece che su disco durante i picchi di concorrenza, per eliminare completamente la latenza di storage dal percorso critico

Dimensionare correttamente pm.max_children in -FPM: un valore troppo basso rifiuta traffico legittimo, uno troppo alto amplifica la pressione su disco e memoria nello stesso momento

Valutare l’hardware: il salto da storage a rotazione a SSD, e da SSD a NVMe, cambia le soglie di r_await/w_await di un ordine di grandezza

Introdurre un livello di come Varnish davanti all’applicazione, una volta che la cache è “primed” e può assorbire la maggior parte delle richieste senza toccare il backend

ConclusioneUn load average alto con CPU libera non è un paradosso: è un sintomo preciso che indica dove guardare. Il metodo — top per una prima ipotesi, iostat e PSI per confermarla a livello di dispositivo, atop/iotop per individuare il processo responsabile, e un benchmark con dd o fio per quantificare il problema in modo indiscutibile — si applica a qualunque stack, dai database ai server web, ed evita di perdere tempo a ottimizzare la CPU quando il vero collo di bottiglia sta girando a 23 MB/s su un disco che dovrebbe farne dieci volte tanto.

Fonte originale: Linux server performance: Is disk I/O slowing your application? – LinuxBlog.io

#linux #guide #howto #tutorial #performance #sysadmin

0

Caricamento...

0
2

Caricamento...

Addio a slmgr.vbs: come attivare Windows con PowerShell prima del tramonto di VBScript

Se nella vostra organizzazione l’attivazione di passa ancora da uno script che richiama slmgr.vbs, incorporato in una sequenza di task di Sys

Altro...

Se nella vostra organizzazione l’attivazione di passa ancora da uno script che richiama slmgr.vbs, incorporato in una sequenza di task di System Center Configuration Manager, in un logon script di Active Directory o in un tool RMM, è arrivato il momento di segnarsi una scadenza in agenda. Microsoft ha confermato che il ritiro di VBScript da Windows procede secondo un piano a fasi, e ha rilasciato in parallelo un modulo ufficiale pensato esplicitamente per sostituire l’automazione basata su slmgr.vbs, cscript.exe e wscript.exe.

Non è un’emergenza immediata: VBScript resta disponibile oggi. Ma chi gestisce parchi macchine di centinaia o migliaia di endpoint sa bene che una migrazione di questo tipo, se rimandata all’ultimo, diventa un incendio da spegnere in corsa. Vediamo cosa cambia, quali sono le tempistiche reali e come impostare fin da ora un piano di migrazione ordinato.

Perché VBScript sta per sparireMicrosoft aveva annunciato la deprecazione di VBScript già nel 2023, come parte di una più ampia strategia di riduzione della superficie di attacco: il motore di scripting legacy è stato per anni un vettore privilegiato per e tecniche di living-off-the-land, e la sua rimozione da Windows segue lo stesso percorso già intrapreso per altre componenti storiche del sistema operativo.

Il piano di ritiro si articola in tre fasi:

Fase attuale — VBScript è presente come Feature on Demand e resta abilitato per impostazione predefinita. Tutto continua a funzionare come sempre.

Fase intermedia (indicativamente dal 2027) — il componente rimarrà disponibile ma verrà disabilitato di default: le organizzazioni che ne hanno ancora bisogno dovranno riattivarlo esplicitamente tramite policy o Feature on Demand.

Fase finale — rimozione completa del motore di scripting da Windows. Microsoft non ha ancora comunicato una data precisa per questo passaggio, ma da quel momento slmgr.vbs e qualunque script dipendente da cscript/wscript smetteranno semplicemente di funzionare.

Il punto critico per i sistemisti è proprio la fase intermedia: se l’automazione di attivazione non viene aggiornata prima che VBScript venga disabilitato di default, i processi di provisioning e le immagini di deployment rischiano di rompersi silenziosamente, magari scoperti solo quando un nuovo lotto di macchine non riesce ad attivarsi.

La sostituzione ufficiale: il modulo PowerShell OSLicensePer coprire il vuoto lasciato da slmgr.vbs, Microsoft ha introdotto OSLicense, un modulo PowerShell nativo pensato per replicare — e in parte estendere — le funzioni storiche dello script VBScript. I cmdlet principali sono tre:

Attivazione online (equivalente di slmgr.vbs /ato)

Invoke-OSLicense -ActivateOnline

Installazione di una product key (equivalente di slmgr.vbs /ipk)

Invoke-OSLicense -InstallProductKey "XXXXX-XXXXX-XXXXX-XXXXX-XXXXX"

Verifica dello stato della licenza (equivalente di slmgr.vbs /dlv)

Get-OSLicenseInfoOltre a questi tre comandi base, OSLicense copre scenari enterprise più articolati: attivazione tramite KMS, attivazione basata su Active Directory (AD-based activation) e la gestione della subscription activation per i piani Windows Enterprise E3/E5. In sostanza, chiunque abbia costruito script di provisioning attorno a slmgr.vbs /skms o /ato troverà un cmdlet equivalente pronto all’uso.

Requisiti per usare OSLicense oggiIl modulo non è ancora universalmente disponibile su tutte le versioni di Windows in campo. Al momento richiede:

Windows 11: l’update opzionale KB5120998 (rilasciato il 27 agosto 2026) o successivo;

Windows Server: è disponibile a partire dalla Windows Server vNext Preview build 29651, quindi non ancora nei rami stabili di produzione.

Questo significa che, per buona parte del parco macchine server oggi in produzione, OSLicense non è un’opzione praticabile nel breve termine — un dettaglio da tenere bene a mente quando si pianifica la migrazione.

Un ponte per chi non può ancora usare OSLicensePer gli ambienti in cui Windows Script Host è già stato disabilitato per policy di sicurezza, o dove serve una soluzione utilizzabile subito senza attendere il rollout di OSLicense sui rami server, la community ha già colmato il divario. Il progetto open source slmgr-ps offre un wrapper PowerShell che replica le funzioni più usate di slmgr.vbs, con il vantaggio aggiuntivo del supporto nativo alle operazioni remote:

Informazioni sulla licenza (locale o estesa)

Get-WindowsActivation
Get-WindowsActivation -Extended
Get-WindowsActivation -Expiry

Attivazione con chiave KMS rilevata automaticamente

Start-WindowsActivation -UseKmsClientKey

Attivazione su una macchina remota

Start-WindowsActivation -Computer WS01

Reset delle impostazioni di attivazione

Reset-WindowsActivation -UninstallProductKey
Reset-WindowsActivation -ClearKMSSettingsA differenza dello script VBScript originale, che opera sempre in locale, questi cmdlet accettano array di nomi macchina: è quindi possibile lanciare un audit o una riattivazione su un intero gruppo di endpoint con un’unica riga di PowerShell, invece di iterare manualmente con psexec o sessioni .

Come impostare la migrazione senza sorpresePrima di riscrivere qualsiasi cosa, il lavoro più importante è capire dove slmgr.vbs è effettivamente referenziato nel proprio ambiente. È un’operazione che conviene affrontare in quattro passaggi:

Censire le dipendenze: cercare riferimenti a slmgr.vbs, cscript.exe e wscript.exe in task sequence MDT/SCCM, script di , GPO di logon/startup, immagini master e tool RMM di terze parti. Un semplice Select-String ricorsivo sui repository di script è un buon punto di partenza.

Classificare per urgenza: separare gli script che girano su Windows 11 con KB5120998 già installabile da quelli su Windows Server, dove OSLicense non è ancora un’opzione e serve necessariamente un ponte come slmgr-ps o una convivenza temporanea con VBScript.

Validare in un anello di test: prima di sostituire uno script di attivazione in produzione, verificarne il comportamento su un gruppo pilota di macchine, controllando in particolare gli scenari KMS e AD-based activation, storicamente i più delicati da replicare fedelmente.

Documentare e pianificare la disattivazione di VBScript: una volta che tutti gli script critici sono stati migrati, pianificare la disabilitazione esplicita del Feature on Demand VBScript sui gruppi di macchine già pronti, così da anticipare la fase di “disabled by default” invece di subirla.

ConclusioneNon c’è ancora motivo di allarmarsi, ma nemmeno di procrastinare. La finestra utile per pianificare con calma la migrazione dell’automazione di attivazione è oggi, non quando VBScript verrà disabilitato di default sui client aggiornati. Le organizzazioni con un parco Windows 11 già aggiornato possono iniziare da subito con OSLicense; chi gestisce prevalentemente Windows Server dovrà invece appoggiarsi a soluzioni ponte come slmgr-ps fino a quando il modulo ufficiale non arriverà nei rami stabili. In entrambi i casi, il primo passo resta lo stesso: sapere esattamente quanti script nel proprio ambiente dipendono ancora da un motore che, prima o poi, non ci sarà più.

Fonte: Petri.com – Windows Activation Automation Must Move Beyond VBScript, con approfondimenti dal Windows IT Pro Blog di Microsoft.

#microsoft #powershell #windows #guide #howto #tutorial

0

Caricamento...

0
1

Caricamento...

Exchange Online blocca i server Exchange 2016 e 2019 non aggiornati: cosa cambia da settembre 2026

Il problema: server Exchange datati che parlano ancora con Exchange OnlineMolte organizzazioni con un deployment ibrido non hanno mai comple

Altro...

Il problema: server Exchange datati che parlano ancora con Exchange OnlineMolte organizzazioni con un deployment ibrido non hanno mai completato la migrazione completa al : mantengono uno o più server Exchange 2016 o 2019 on-premises esclusivamente per gestire l’autenticazione, i connettori di posta o alcuni carichi di lavoro legacy, mentre il grosso delle cassette postali vive già su Exchange Online. È un’architettura comune, ma comporta un rischio spesso sottovalutato: se quel server ibrido non viene aggiornato, diventa silenziosamente un anello debole nella catena di sicurezza dell’intero tenant.

Microsoft ha deciso di intervenire con un piano di enforcement che, a partire dalla seconda settimana di settembre 2026, comincerà a limitare e infine a bloccare i messaggi provenienti da server Exchange 2016 e 2019 che non rispettano una baseline minima di aggiornamento. La notizia è particolarmente rilevante perché il calendario coincide con questi stessi giorni: chi gestisce un ambiente ibrido dovrebbe verificare la propria postura di patching immediatamente, non “quando avrà tempo”.

Cosa cambia esattamenteIl meccanismo riguarda specificamente i server che inviano posta a Exchange Online attraverso un connettore in ingresso di tipo OnPremises: è la configurazione tipica di un ambiente , dove il server locale viene autorizzato a inoltrare la posta al cloud bypassando alcuni controlli anti-spam standard, sulla base di una relazione di fiducia. È proprio questa fiducia implicita che Microsoft vuole condizionare a un livello di patching adeguato.

La baseline richiesta è quella dell’ultimo aggiornamento di sicurezza pubblico rilasciato per queste versioni, ovvero il Security Update di ottobre 2025 (Oct25SU) — l’ultimo pacchetto di sicurezza pubblicamente disponibile prima che queste entrassero nella fase di solo supporto esteso. In pratica, i livelli minimi accettati sono:

Exchange 2016 CU23 + Oct25SU → build 15.1.2507.61

Exchange 2019 CU15 + Oct25SU → build 15.2.1748.39

Exchange 2019 CU14 + Oct25SU → build 15.2.1544.36

Un dettaglio che genera spesso confusione: verificare di avere installato il CU corretto non basta. Bisogna controllare la build completa, perché due server sullo stesso Cumulative Update possono trovarsi a livelli di di sicurezza diversi se uno dei due ha saltato l’ultimo rollup.

Come si manifesta l’enforcementIl processo segue tre fasi progressive, già collaudate da Microsoft su altre versioni obsolete di Exchange in passato: segnalazione, throttling e infine blocco.

ThrottlingNella fase di rallentamento, Exchange Online ritarda deliberatamente l’accettazione dei messaggi in arrivo dai server non conformi. Il sintomo tipico è un accumulo di code sul server mittente, con retry ripetuti: da fuori sembra un problema di congestione della rete o del server, e questo rende il throttling insidioso da diagnosticare se non si sa cosa cercare.

BloccoSuperata la fase di throttling, i messaggi vengono respinti in modo esplicito, generando NDR (non-delivery report) per i mittenti. A quel punto il problema diventa visibile a tutti — utenti compresi — ma nel frattempo l’organizzazione avrà già perso giorni preziosi di consegna della posta.

Come verificare la propria esposizioneIl primo passo è capire quali server nel proprio ambiente utilizzano effettivamente un connettore OnPremises. Da Exchange Online :

Get-InboundConnector |
Where-Object ConnectorType -eq 'OnPremises' |
Format-List Name,Enabled,SenderIPAddresses,TlsSenderCertificateNameQuesto comando elenca i connettori attivi e gli indirizzi IP autorizzati a inviare posta attraverso di essi: è la mappa di partenza per capire quali server on-premises sono coinvolti.

Sul singolo server Exchange, la versione esatta della build si verifica interrogando ExSetup.exe, molto più affidabile del semplice numero di build mostrato nell’Exchange Admin Center:

Get-Command ExSetup.exe |
ForEach-Object { $_.FileVersionInfo } |
Format-List ProductVersion,FileVersion,FileNamePer un controllo più ampio, che copra anche altri parametri di del server (certificati in scadenza, servizi non funzionanti, configurazioni TLS deboli), vale la pena eseguire lo script Exchange Health Checker, lo strumento diagnostico ufficiale mantenuto dal team Exchange su , che segnala automaticamente anche gli scostamenti dalla baseline di sicurezza raccomandata.

Cosa fare prima della scadenzaIl piano d’azione per chi si trova sotto la baseline è relativamente lineare, ma richiede una finestra di manutenzione pianificata con attenzione:

Individuare tutti i server che instradano posta tramite connettori OnPremises e verificarne la build esatta.

Programmare l’installazione dell’aggiornamento di sicurezza di ottobre 2025 (o successivo, se nel frattempo Microsoft ne rilascia uno più recente per questi rami) durante una finestra di manutenzione, con riavvio del server.

Ripetere la verifica della build dopo il riavvio: un’installazione fallita silenziosamente è più comune di quanto si pensi.

Testare i percorsi di failover e i bilanciamenti di carico se si dispone di più server ibridi, per assicurarsi che l’aggiornamento non abbia introdotto regressioni nel routing della posta.

Chi non riesce a completare l’aggiornamento entro i tempi può richiedere una esenzione temporanea, valida fino a 90 giorni per tenant per anno solare (frazionabile in più blocchi), tramite l’Exchange Admin Center o il cmdlet dedicato alla gestione delle esenzioni di enforcement. È una valvola di sfogo utile per chi ha vincoli di change management stringenti, ma va vista come un rinvio, non come una soluzione: la strada obbligata resta l’aggiornamento, oppure — nel medio termine — la migrazione a Exchange Server Subscription Edition o il completamento dello spostamento delle cassette postali residue su Exchange Online.

ConclusioneQuesto enforcement non è un capriccio burocratico: i server Exchange ibridi non aggiornati sono uno dei vettori più sfruttati per compromissioni che, partendo dalla posta, arrivano fino ad Active Directory. Microsoft sta semplicemente smettendo di fidarsi implicitamente di infrastrutture che non dimostrano di essere mantenute in modo attivo. Per i sistemisti che gestiscono ambienti ibridi, il consiglio pratico è di eseguire subito i comandi PowerShell indicati sopra, capire la propria esposizione reale e pianificare l’aggiornamento prima che il throttling si trasformi in un incidente di produzione con gli utenti che segnalano email in ritardo o mai arrivate.

Fonte: Practical365 e Microsoft Tech Community.

#windows #guide #tutorial #net

0

Caricamento...

0
1

Caricamento...

Cronologia Bash su Linux: HISTFILE, HISTTIMEFORMAT e scorciatoie per sistemisti

Chiunque amministri sistemi passa gran parte della giornata dentro una shell, e la cronologia dei comandi (history) è probabilmente lo strument

Altro...

Chiunque amministri sistemi passa gran parte della giornata dentro una shell, e la cronologia dei comandi (history) è probabilmente lo strumento più usato e meno conosciuto a fondo. Sappiamo tutti premere la freccia su o lanciare Ctrl+R, ma pochi sfruttano davvero le variabili che controllano cosa viene salvato, come viene formattato e come sincronizzarlo tra più terminali aperti in contemporanea. Vediamo come portare la gestione della cronologia a un livello professionale, con configurazioni pronte per essere messe in produzione su server multi-utente.

Le variabili che governano la cronologiaBash tiene traccia dei comandi in due posti distinti: la memoria della sessione corrente e il file su disco (di default ~/.bash_history). Questa distinzione è la fonte di gran parte della confusione quando si lavora con più terminali aperti, quindi vale la pena chiarirla subito con le variabili che la controllano.

HISTSIZE e HISTFILESIZEHISTSIZE stabilisce quanti comandi restano in memoria durante la sessione attiva, mentre HISTFILESIZE determina quante righe vengono conservate nel file su disco. Sono due limiti indipendenti: si può avere una sessione “leggera” con poche centinaia di comandi in memoria ma un archivio storico molto più ampio su disco.

export HISTSIZE=10000
export HISTFILESIZE=20000Impostare un valore negativo (o vuoto) rende la cronologia illimitata: sconsigliato su sistemi condivisi, dove un file di history che cresce senza controllo può diventare un problema sia di che di sicurezza.

HISTFILEHISTFILE indica dove viene scritta la cronologia. Il default è ~/.bash_history, ma è possibile ridirigerla altrove, ad esempio per tenere una history separata per progetto o per sessioni di audit:

export HISTFILE="$HOME/.bash_history_$(date +%Y%m)"HISTTIMEFORMAT: i timestamp che quasi nessuno abilitaPer impostazione predefinita, history non mostra quando un comando è stato eseguito. Abilitare i timestamp con HISTTIMEFORMAT è probabilmente l’impostazione a più alto rapporto beneficio/sforzo di questo articolo, specialmente in fase di troubleshooting: sapere che un comando è stato lanciato tre minuti prima di un incidente è un’informazione preziosa.

export HISTTIMEFORMAT="%F %T "Con questa impostazione, history | grep nginx restituirà righe del tipo:

1042 2026-09-03 10:14:02 systemctl reload nginxUn dettaglio tecnico da tenere a mente: il timestamp viene registrato internamente come epoch Unix ad ogni comando, ma diventa visibile solo se HISTTIMEFORMAT è impostato prima che i comandi vengano eseguiti. Se lo si abilita a metà sessione, i comandi precedenti non avranno un timestamp recuperabile.

HISTCONTROL: cosa non salvareHISTCONTROL filtra cosa in cronologia:

ignorespace – esclude i comandi che iniziano con uno spazio (utile per non salvare comandi con o token inline)

ignoredups – salta i duplicati consecutivi

ignoreboth – combina entrambi i comportamenti precedenti

erasedups – rimuove tutte le occorrenze precedenti di un comando ripetuto, non solo quelle consecutive

export HISTCONTROL=ignorebothIl trucco di ignorespace è particolarmente utile: basta digitare un comando con uno spazio iniziale (es.  curl -H "Authorization: Bearer xyz..." ...) per evitare che token o credenziali finiscano nel file di history in chiaro.

HISTIGNORE: filtrare per patternHISTIGNORE permette di escludere dalla cronologia comandi ricorrenti e poco utili come ls, cd o pwd. Attenzione: i pattern ancorano l’inizio della riga e devono corrispondere all’intero comando, quindi vanno elencati esplicitamente anche gli argomenti comuni.

export HISTIGNORE="ls:ll:la:cd:cd -:pwd:exit:date:clear:history"Le opzioni della shell: histappend e histverifyDue shopt completano la configurazione di base. La prima è quasi obbligatoria su qualunque sistema con più terminali:

shopt -s histappendSenza histappend, Bash sovrascrive il file HISTFILE alla chiusura della shell con il contenuto della sessione corrente, perdendo i comandi salvati da altri terminali chiusi nel frattempo. Con histappend attivo, ogni sessione aggiunge in coda invece di sovrascrivere.

La seconda opzione utile è histverify, che intercetta le espansioni di history (come !! o !497) e le mostra sul prompt per una conferma, invece di eseguirle immediatamente:

shopt -s histverifyQuesto piccolo accorgimento evita un classico incidente: digitare !42 pensando che sia un comando innocuo e scoprire, dopo l’esecuzione, che il comando numero 42 era un rm -rf lanciato ore prima in un altro contesto.

Sincronizzare la cronologia tra terminali multipliPer chi lavora con molte finestre o sessioni tmux/screen aperte in parallelo, il comportamento di default di Bash è frustrante: ogni shell scrive la propria history solo alla chiusura, quindi i comandi digitati in un terminale non sono visibili negli altri finché non li si chiude esplicitamente.

La soluzione è agganciare la scrittura e la ricarica della history a PROMPT_COMMAND, che Bash esegue prima di ogni visualizzazione del prompt:

PROMPT_COMMAND="history -a; history -c; history -r${PROMPT_COMMAND:+; $PROMPT_COMMAND}"Scomponendo la sequenza:

history -a – accoda immediatamente su disco i nuovi comandi della sessione

history -c – svuota la lista in memoria della sessione corrente

history -r – ricarica in memoria l’intero file, inclusi i comandi scritti da altre sessioni

Il risultato: la freccia su e Ctrl+R attingono a una cronologia condivisa e aggiornata quasi in tempo reale tra tutti i terminali aperti. Il costo è un piccolo overhead ad ogni prompt, generalmente trascurabile salvo file di history molto grandi; in quel caso è preferibile una variante più leggera con history -n, che solo le righe nuove invece di ricaricare l’intero file:

PROMPT_COMMAND="history -a; history -n${PROMPT_COMMAND:+; $PROMPT_COMMAND}"Comandi di gestione della historyOltre alle variabili di ambiente, il builtin history offre diverse operazioni utili in amministrazione quotidiana:

Mostra tutta la cronologia con numerazione

history

Ultimi 20 comandi

history 20

Cerca nella cronologia

history | grep nginx

Scrive subito su disco la sessione corrente

history -a

Elimina una riga specifica dalla memoria (es. riga 497)

history -d 497

Elimina e persiste la rimozione sul file

history -d 497 && history -w

Svuota completamente memoria e file

history -c && history -wPer disabilitare temporaneamente la registrazione, ad esempio prima di digitare una password su un comando che non supporta variabili d’ambiente:

set +o history

comandi non registrati qui

set -o historyLe scorciatoie da tastiera che valgono la pena imparareOltre al classico Ctrl+R per la ricerca incrementale, Bash espone un intero linguaggio di espansione della history, largamente sotto-utilizzato:

ScorciatoiaFunzione!!Ripete l’ultimo comando!$Ultimo argomento del comando precedente!^Primo argomento del comando precedente!*Tutti gli argomenti del comando precedente!NEsegue il comando numero N!stringaUltimo comando che inizia con “stringa”!stringa:pMostra il comando senza eseguirlo (preview)^vecchio^nuovoSostituisce e rilancia l’ultimo comandoAlt+.Richiama ciclicamente l’ultimo argomento dei comandi precedenti!$ in particolare è utile più spesso di quanto sembri: dopo mkdir /var/log/miaapp, digitare cd !$ evita di riscrivere il percorso.

Ricerca interattiva avanzata con fzfPer chi trova Ctrl+R limitante, fzf lo sostituisce con un fuzzy finder interattivo molto più potente:

sudo apt install fzf # Debian/Ubuntu
eval "$(fzf --bash)" # da aggiungere a ~/.bashrcUna volta configurato, Ctrl+R apre un filtro interattivo con evidenziazione live: premendo Invio la prima volta il comando viene incollato sul prompt (non eseguito), permettendo di modificarlo prima del lancio effettivo.

Sicurezza: la history non è un controllo, è un logAlcuni punti da tenere presenti quando si gestiscono cronologie su sistemi condivisi o in produzione:

Il file di history dovrebbe avere permessi restrittivi: chmod 600 ~/.bash_history

ignorespace nasconde un comando dalla history solo se lo spazio iniziale viene digitato manualmente: non è un meccanismo automatico

File di history su NFS o directory sincronizzate (Dropbox, syncthing, ecc.) possono esporre comandi sensibili a più host

La cronologia è auditabile dall’utente stesso ma non è un controllo di sicurezza: chiunque abbia accesso alla shell può disabilitarla con set +o history o cancellarla

Per un audit trail affidabile in produzione, la history di Bash va affiancata (non sostituita) da strumenti dedicati come auditd o da logging centralizzato della sessione shell

Configurazione completa consigliataRiassumendo tutto quanto visto in un blocco pronto per ~/.bashrc:

Configurazione History Bash

HISTSIZE=10000
HISTFILESIZE=20000
HISTTIMEFORMAT="%F %T "
HISTCONTROL=ignoreboth
HISTIGNORE="ls:ll:la:cd:cd -:pwd:exit:date:clear:history"

shopt -s histappend
shopt -s histverify

Sincronizza la cronologia tra terminali dopo ogni comando

PROMPT_COMMAND="history -a; history -c; history -r${PROMPT_COMMAND:+; $PROMPT_COMMAND}"Dopo averla incollata, applicarla con:

source ~/.bashrcConclusioneLa cronologia di Bash è uno di quegli strumenti che si usano per anni senza mai configurarli davvero. Pochi minuti spesi su HISTTIMEFORMAT, HISTCONTROL e la sincronizzazione via PROMPT_COMMAND trasformano un log grezzo e volatile in uno strumento di troubleshooting affidabile, specialmente su server dove si lavora regolarmente da più sessioni contemporanee. Per chi gestisce ambienti multi-utente, vale la pena ricordare che la history resta comunque uno strumento lato client: per l’audit reale servono log centralizzati indipendenti dalla volontà dell’utente.

Fonte originale: Master Linux Bash History with historyctl, HISTFILE, and Shortcuts – LinuxBlog.io

#linux #guide #howto #tutorial #bash

0

Caricamento...

0
1

Caricamento...

Debian 11 è a fine vita: la guida completa per l’upgrade a Debian 12

Il 31 agosto 2026 Debian 11 “Bullseye” ha ufficialmente raggiunto l’end-of-life: da settembre il progetto Debian non rilascia più aggiornamenti di [si

Altro...

Il 31 agosto 2026 Debian 11 “Bullseye” ha ufficialmente raggiunto l’end-of-life: da settembre il progetto Debian non rilascia più aggiornamenti di sicurezza per questa . Chi gestisce server, o workstation ancora basati su Bullseye si trova quindi davanti a una finestra di rischio che va chiusa al più presto, spostando i sistemi su Debian 12 “Bookworm” o valutando un percorso alternativo di supporto esteso. In questo articolo vediamo cosa comporta davvero la fine del supporto, quali sono le opzioni disponibili e come eseguire l’upgrade in modo controllato, senza sorprese in produzione.

Perché la fine del supporto non è un dettaglio burocraticoDebian 11 è stato rilasciato il 14 agosto 2021 e, seguendo il classico ciclo di vita quinquennale del progetto (circa tre anni di supporto regolare più un periodo di Long Term Support gestito dal team LTS), ha chiuso il proprio percorso di manutenzione ufficiale il 31 agosto 2026. Da questo momento in poi, nessuna vulnerabilità scoperta nei pacchetti di Bullseye — dal a , da Apache a — riceverà più una attraverso i canali ufficiali security.debian.org.

Per un sistema esposto su , anche solo per un servizio SSH o un endpoint HTTP, questo significa che ogni nuova resta aperta indefinitamente. Non è un problema teorico: gli scanner automatizzati che individuano versioni di pacchetto vulnerabili sono tra gli strumenti più usati per la ricognizione iniziale di un attacco, e un sistema Debian 11 “congelato” diventa un bersaglio sempre più facile man mano che passano i mesi.

Le opzioni sul tavoloChi si trova ancora su Bullseye ha essenzialmente tre strade:

Upgrade a Debian 12 “Bookworm”, attualmente la release seguita dal team Debian LTS con supporto pianificato fino al 30 giugno 2028 per le architetture principali (amd64, i386, arm64, armhf, ppc64el). È la scelta consigliata per la maggior parte degli ambienti.

Extended LTS (ELTS), un programma a pagamento gestito da fornitori esterni (tipicamente tramite Freexian) che estende il supporto di sicurezza per un sottoinsieme di pacchetti Bullseye oltre la data di EOL ufficiale. Utile come misura ponte quando l’upgrade richiede una pianificazione più lunga, non come soluzione permanente.

Migrazione diretta a Debian 13 “Trixie” per chi preferisce saltare una generazione e allineare fin da subito il ciclo di vita, tenendo però conto che il salto tra due major release comporta più rischio di rottura in un’unica finestra di manutenzione.

Cosa cambia passando a BookwormDebian 12 introduce alcune differenze che vale la pena conoscere prima di lanciare l’upgrade, perché possono impattare configurazioni esistenti:

Kernel Linux 6.1 come base, con supporto hardware più recente ma anche nomi dei moduli e comportamenti di alcuni driver che possono differire da quelli di Bullseye (kernel 5.10).

Introduzione del componente non-free-firmware, separato da non-free: i firmware proprietari (Wi-Fi, GPU, RAID controller) vanno ora dichiarati esplicitamente in questa sezione dei repository, altrimenti l’installer o l’upgrade potrebbero non trovarli.

Versioni aggiornate dei runtime più comuni: PHP 8.2, Python 3.11, MariaDB 10.11, il che può richiedere una verifica di compatibilità per applicazioni legacy prima di procedere.

systemd, APT e le librerie di base aggiornate, con conseguente necessità di rispondere a diversi prompt di merge sui file di configurazione durante l’upgrade (in particolare per servizi come SSH, sudo o cron con configurazioni personalizzate).

Checklist pre-upgradePrima di toccare qualsiasi repository, vale la pena dedicare mezz’ora a una checklist minima:

Backup completo del sistema o quantomeno di /etc, dei database e dei dati applicativi, con un piano di rollback (snapshot LVM, snapshot del provider cloud, o immagine del disco).

Verifica dello spazio disco disponibile: l’upgrade scarica e mantiene temporaneamente sia i pacchetti vecchi che quelli nuovi.

Controllo dei repository di terze parti (Docker, PPA non ufficiali, repository di vendor) che potrebbero non avere ancora pacchetti per Bookworm: vanno disabilitati temporaneamente per evitare conflitti di dipendenze.

Elenco dei pacchetti “held” (apt-mark showhold) e di eventuali pacchetti installati manualmente al di fuori di APT.

Se possibile, replica del test su un ambiente di staging identico prima di intervenire sui sistemi di produzione.

La procedura di upgrade passo per passoUna volta completata la checklist, la sequenza classica per un upgrade in-place è la seguente.

  1. Portare Bullseye completamente aggiornatosudo apt update
    sudo apt upgrade
    sudo apt --purge autoremove
    Questo passaggio riduce il numero di pacchetti coinvolti nel salto di release e rimuove pacchetti orfani che potrebbero complicare la risoluzione delle dipendenze.

  2. Aggiornare i repository APTSi modifica /etc/apt/sources.list (e gli eventuali file in /etc/apt/sources.list.d/) sostituendo ogni occorrenza di bullseye con bookworm, ricordandosi di aggiungere il componente non-free-firmware:

deb https://deb.debian.org/debian/ bookworm main contrib non-free non-free-firmware
deb https://deb.debian.org/debian/ bookworm-updates main contrib non-free non-free-firmware
deb https://security.debian.org/debian-security bookworm-security main contrib non-free non-free-firmware
3. Eseguire l’upgrade in due fasisudo apt update
sudo apt upgrade --without-new-pkgs
sudo apt full-upgrade
Il primo upgrade --without-new-pkgs applica gli aggiornamenti possibili senza installare nuovi pacchetti o rimuoverne di esistenti, riducendo il rischio di un salto troppo aggressivo in un solo colpo. Il successivo full-upgrade completa la transizione gestendo anche i cambi di dipendenze tra le due release, incluse eventuali rimozioni di pacchetti obsoleti.

Durante questa fase compariranno i prompt interattivi di dpkg per i file di configurazione modificati localmente: la scelta più sicura, quando non si è certi, è mantenere la versione locale e rivedere manualmente i diff dei file più critici (sshd_config, sudoers, i file di configurazione dei servizi applicativi) dopo il reboot.

  1. Riavvio e verificasudo systemctl reboot
    Dopo il riavvio, si conferma la versione effettivamente in esecuzione:

lsb_release -a
cat /etc/debian_version
ed è buona pratica eseguire un ultimo giro di pulizia:

sudo apt --purge autoremove
sudo apt clean
Errori comuni da evitareSaltare il passaggio intermedio --without-new-pkgs e lanciare direttamente full-upgrade: funziona quasi sempre, ma su sistemi con molte dipendenze di terze parti aumenta la probabilità di un errore a metà upgrade più difficile da diagnosticare.

Dimenticare i repository esterni (Docker CE, repository PHP di terze parti, agent di monitoring): se restano puntati su bullseye l’upgrade può fallire silenziosamente su quei pacchetti specifici, lasciandoli disallineati dal resto del sistema.

Non verificare la compatibilità delle applicazioni con le nuove versioni di PHP, Python o del database: un salto di versione major di MariaDB o PHP può introdurre breaking change che vanno testati prima, non scoperti in produzione.

Ignorare i pacchetti “held” o compilati manualmente, che possono bloccare la risoluzione delle dipendenze durante il full-upgrade.

Se l’upgrade immediato non è possibileNon tutti gli ambienti possono essere aggiornati nel giro di pochi giorni: applicazioni legacy, certificazioni che richiedono test approfonditi, o semplicemente la mole di sistemi da migrare possono richiedere più tempo. In questi casi, il programma Extended LTS è una misura transitoria ragionevole per coprire le vulnerabilità più critiche mentre si pianifica la migrazione, ma va trattato come tale: un ponte verso Bookworm, non una destinazione finale. Rimandare indefinitamente l’upgrade lasciando un sistema esposto senza patch di sicurezza è il rischio che questa intera operazione serve a evitare.

ConclusioneLa fine del supporto di Debian 11 è un promemoria puntuale di una regola che vale per qualunque distribuzione con ciclo di vita a tempo: pianificare l’upgrade prima della scadenza costa una manutenzione ordinaria, farlo dopo — o non farlo affatto — costa un incidente di sicurezza. La procedura verso Debian 12 è ben collaudata e, con un backup solido e una checklist pre-upgrade seguita con disciplina, resta uno degli aggiornamenti major più prevedibili nell’ecosistema Linux.

Fonte: 4sysops – Debian 11 LTS ends: upgrade to Debian 12 before updates stop, con riferimento all’annuncio ufficiale del progetto Debian.

#linux #guide #howto #tutorial

0

Caricamento...

0
2

Caricamento...

Tuning del kernel Linux con sysctl: i parametri che contano davvero in produzione

Chiunque gestisca server Linux in produzione, prima o poi, si scontra con lo stesso muro: l’hardware non è il collo di bottiglia, lo sono i valori di

Altro...

Chiunque gestisca server Linux in produzione, prima o poi, si scontra con lo stesso muro: l’hardware non è il collo di bottiglia, lo sono i valori di default del kernel. Un server con dischi NVMe e una scheda di rete da 10 Gbps che fatica a superare poche centinaia di connessioni simultanee, o che soffre di latenza inspiegabile sotto carico, nella stragrande maggioranza dei casi non ha un problema di risorse: ha un problema di tuning.

Il kernel Linux espone centinaia di parametri regolabili a runtime tramite l’interfaccia sysctl, che agisce sull’albero /proc/sys/. Sono impostazioni pensate per andare bene “in media” su qualunque macchina, dal Raspberry Pi al server con 512 GB di RAM. Per un ambiente di produzione, però, “in media” spesso non basta. Vediamo quali parametri contano davvero, perché, e come applicarli senza rischiare di rompere il sistema.

Come funziona sysctlPrima di toccare qualunque valore è utile ripassare i comandi base. sysctl permette di leggere e modificare i parametri kernel senza riavviare la macchina:

Elencare tutti i parametri disponibili

sysctl -a

Leggere un singolo parametro

sysctl net.ipv4.tcp_syncookies

Modificarlo temporaneamente (non sopravvive al riavvio)

sudo sysctl -w net.ipv4.tcp_syncookies=1Per rendere le modifiche permanenti, la pratica corretta è creare un file dedicato sotto /etc/sysctl.d/ — evitando di editare direttamente /etc/sysctl.conf, che su molte distribuzioni convive male con i pacchetti che installano le proprie regole:

sudo nano /etc/sysctl.d/99-tuning.conf
sudo sysctl --system # applica tutti i file in /etc/sysctl.d/Rete: buffer TCP e gestione delle connessioniSui server con traffico sostenuto, i buffer TCP di default sono quasi sempre troppo piccoli. Il kernel alloca dinamicamente memoria per i socket entro i limiti impostati da questi tre valori (minimo, default, massimo, in byte):

net.ipv4.tcp_rmem = 4096 87380 67108864
net.ipv4.tcp_wmem = 4096 65536 67108864
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864Alzare il massimo a 64 MB ha senso soprattutto su link ad alta banda e alta latenza (data center distanti, CDN, replica di database geografica), dove il bandwidth-delay product richiede finestre TCP più ampie per saturare il collegamento.

Altrettanto importante è la gestione della coda di connessioni in ingresso, che su un server esposto a picchi di traffico determina quante richieste vengono accettate prima di iniziare a scartarle:

net.ipv4.tcp_max_syn_backlog = 8192
net.core.somaxconn = 65535
net.core.netdev_max_backlog = 16384
net.ipv4.tcp_syncookies = 1somaxconn in particolare va allineato al backlog configurato lato applicazione (nginx, HAProxy, il socket listener della tua app .NET o Node): se l’applicazione chiede una coda più grande di quella permessa dal kernel, il valore effettivo resta quello più basso.

Attivare BBR come algoritmo di congestion controlIl cambiamento con il rapporto costo/beneficio più alto per la maggior parte dei server moderni è probabilmente il passaggio da CUBIC a BBR come algoritmo di controllo della congestione. CUBIC reagisce alla perdita di pacchetti: aumenta la finestra di invio finché non rileva un drop, poi la dimezza. È un approccio reattivo che su reti con perdita “di fondo” non dovuta a congestione (Wi-Fi, mobile, certi link satellitari) penalizza inutilmente il throughput.

BBR, sviluppato da Google e stabile nei kernel a partire dalla serie 4.9, funziona in modo diverso: stima attivamente il bandwidth-delay product del percorso di rete e modula l’invio di conseguenza, senza aspettare la perdita di pacchetti come segnale. Sui kernel 5.15 e 6.x l’implementazione è ulteriormente raffinata (il set di funzionalità informalmente indicato come “BBRv3”), ma non serve aggiornare il kernel apposta: se hai già un kernel recente, BBR c’è già, va solo abilitato.

Verifica gli algoritmi disponibili

sysctl net.ipv4.tcp_available_congestion_control

Se necessario, carica il modulo

sudo modprobe tcp_bbr
echo tcp_bbr | sudo tee /etc/modules-load.d/tcp-bbr.confE nel file di configurazione:

net.ipv4.tcp_congestion_control = bbr
net.core.default_qdisc = fqIl secondo parametro non è opzionale: BBR è stato progettato e testato insieme alla queue discipline fq (fair queue con pacing), e usarlo con la pfifo_fast di default riduce buona parte del beneficio. Dopo l’attivazione, verifica con:

sysctl net.ipv4.tcp_congestion_control
ss -tin | grep bbrMemoria: swap, cache e writebackIl secondo fronte dove i default fanno più danni è la gestione della memoria, in particolare su server con molta RAM dedicati a database o applicazioni in-memory.

vm.swappiness = 10
vm.vfs_cache_pressure = 50swappiness (range 0-200, default 60) determina quanto aggressivamente il kernel sposta pagine di memoria su swap invece di liberare cache. Un valore basso come 10 dice al kernel di preferire fortemente la RAM fisica e di ricorrere allo swap solo quando davvero necessario — comportamento quasi sempre desiderabile su un server con database, dove uno swap-in inatteso su una query critica si traduce in latenza a due cifre percentuali più alta. vfs_cache_pressure più basso del default (100) fa sì che il kernel trattenga più a lungo la cache di metadati e dentry, utile su filesystem con molti file piccoli.

Altrettanto rilevante è il comportamento di scrittura delle pagine “sporche” (dirty), cioè modificate in memoria ma non ancora sincronizzate su disco:

vm.dirty_ratio = 10
vm.dirty_background_ratio = 5
vm.dirty_expire_centisecs = 1500
vm.dirty_writeback_centisecs = 250Con i default (rispettivamente 20 e 10, spesso più alti su alcune distribuzioni), un server con molta RAM può accumulare diversi gigabyte di dati non ancora scritti su disco prima che il kernel forzi il flush — e quando lo fa, l’intero sistema può bloccarsi per secondi mentre scrive tutto in una volta. Abbassare le soglie distribuisce il lavoro di scrittura in modo più uniforme, a costo di un overhead I/O leggermente maggiore ma costante. Su macchine con centinaia di GB di RAM, conviene passare dai valori percentuali a limiti assoluti in byte (vm.dirty_bytes, vm.dirty_background_bytes), perché una percentuale del 10% su 512 GB di RAM è comunque troppo.

File descriptor e limiti di sistemaUn errore classico su server che gestiscono molte connessioni concorrenti (web server, message broker, database con molti client) è l’esaurimento dei file descriptor disponibili:

fs.file-max = 2097152
fs.nr_open = 1048576
fs.inotify.max_user_watches = 524288Quest’ultimo parametro merita attenzione particolare: inotify.max_user_watches troppo basso è la causa più comune dell’errore “too many open files” riportato da strumenti come Webpack dev server, editor con file watching, o sistemi di sincronizzazione che monitorano grandi alberi di directory — non ha nulla a che fare con i socket di rete, ma con il numero di file che il kernel può tenere sotto osservazione per notifiche di modifica.

Sicurezza di reteUn piccolo set di parametri riduce la superficie d’attacco a livello di stack di rete senza impatto sulle prestazioni:

net.ipv4.icmp_echo_ignore_broadcasts = 1
net.ipv4.conf.all.rp_filter = 1
net.ipv4.conf.all.accept_source_route = 0
net.ipv4.conf.all.accept_redirects = 0
net.ipv4.conf.all.send_redirects = 0
net.ipv4.conf.all.log_martians = 1rp_filter (reverse path filtering) merita una nota: impostato a 1 (strict mode) rifiuta pacchetti il cui indirizzo sorgente non è raggiungibile tramite l’interfaccia su cui sono arrivati, mitigando IP spoofing. È la scelta giusta per la maggior parte dei server, ma su macchine con routing asimmetrico — tipicamente setup multihomed, alcune configurazioni VPN o BGP — va impostato a 2 (loose mode), altrimenti si rischia di scartare traffico legittimo.

Un parametro storico da NON usareVale la pena segnalarlo esplicitamente perché gira ancora in vecchie guide copiate e incollate da un blog all’altro: net.ipv4.tcp_tw_recycle è stato rimosso dal kernel a partire dalla versione 4.12 perché causava problemi seri dietro NAT (connessioni rifiutate in modo intermittente e difficile da diagnosticare). Se lo trovate in un file sysctl.conf ereditato da un vecchio sistema, va rimosso: su kernel recenti l’impostazione viene semplicemente ignorata, ma la sua presenza è un segnale che quella configurazione non è stata rivista da anni.

Applicare e verificareMettendo insieme i parametri discussi in un unico file di configurazione:

/etc/sysctl.d/99-tuning.conf

Rete: buffer TCP

net.ipv4.tcp_rmem = 4096 87380 67108864
net.ipv4.tcp_wmem = 4096 65536 67108864
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864

Rete: congestion control

net.ipv4.tcp_congestion_control = bbr
net.core.default_qdisc = fq

Rete: gestione connessioni

net.ipv4.tcp_max_syn_backlog = 8192
net.core.somaxconn = 65535
net.core.netdev_max_backlog = 16384
net.ipv4.tcp_syncookies = 1

Memoria

vm.swappiness = 10
vm.vfs_cache_pressure = 50
vm.dirty_ratio = 10
vm.dirty_background_ratio = 5

File descriptor

fs.file-max = 2097152
fs.inotify.max_user_watches = 524288

Sicurezza

net.ipv4.conf.all.rp_filter = 1
net.ipv4.conf.all.accept_source_route = 0
net.ipv4.conf.all.accept_redirects = 0
net.ipv4.conf.all.log_martians = 1Dopo l’applicazione con sudo sysctl --system, alcuni controlli utili per confermare che tutto sia entrato in vigore:

sysctl net.ipv4.tcp_congestion_control
cat /proc/sys/fs/file-nr
cat /proc/meminfo | grep -i dirty
sudo dmesg | tail -20ConclusioneNessuno di questi parametri va applicato alla cieca copiando un file da internet, incluso questo. Ogni ambiente ha un profilo di carico diverso — un database transazionale, un reverse proxy ad alto traffico e un batch processor hanno esigenze di memoria e rete molto differenti — e il modo corretto di procedere è cambiare pochi parametri alla volta, misurare, e tenere traccia di cosa è stato modificato e perché, magari versionando il file sysctl.d insieme al resto della configurazione infrastrutturale. Il vantaggio di sysctl è proprio questo: ogni modifica è reversibile a runtime, il che rende il tuning un processo iterativo e sicuro invece che un salto nel buio a ogni riavvio.

Fonte originale: Linux Kernel Parameters Tuning for Better Performance, LinuxBlog.io.

#linux #devops #guide #howto #tutorial #performance #kernel

0

Caricamento...

0
1

Caricamento...

Da Active Directory a Entra ID: la modernizzazione ibrida dell’identità spiegata ai sistemisti

Perché Active Directory da sola non basta piùMicrosoft ha recentemente pubblicato un messaggio diretto ai reparti IT: Active Directory on-premises, da

Altro...

Perché Active Directory da sola non basta piùMicrosoft ha recentemente pubblicato un messaggio diretto ai reparti IT: Active Directory on-premises, da sola, non è più sufficiente per reggere il modello di sicurezza richiesto oggi. Non si tratta di un annuncio di fine vita per AD — che resta il fondamento dell’identità in moltissime organizzazioni — ma di un cambio di prospettiva su cosa un’infrastruttura identity debba garantire quando lavoro ibrido, SaaS, fornitori esterni e ora anche agenti AI accedono quotidianamente a dati e sistemi aziendali.

Per chi gestisce l’infrastruttura identity in produzione, la domanda non è “AD oppure Entra ID”, ma come costruire un’architettura ibrida che riduca la superficie d’attacco senza un rip-and-replace che nella maggior parte dei contesti enterprise non è realistico né necessario. Vediamo cosa cambia concretamente e quali strumenti usare per la modernizzazione incrementale.

I cinque segnali di un’infrastruttura identity da modernizzareIl ragionamento di Microsoft si basa su cinque aree di attrito che chi amministra AD riconoscerà facilmente:

Onere operativo: patching dei domain controller, gestione backup, rinnovo certificati, procedure di disaster recovery. Tempo sottratto ad automazione e governance, non alla sicurezza in sé.

Un modello di trust superato: AD è nato per un perimetro di rete definito. Il lavoro ibrido richiede decisioni di accesso basate su rischio dell’utente, postura del dispositivo e contesto — non sulla semplice appartenenza alla rete aziendale.

Proliferazione SaaS: Microsoft 365, Salesforce, Workday, ServiceNow e decine di altre applicazioni cloud richiedono un piano di identità cloud-native, non solo una federazione con AD.

Utenti esterni: contractor, partner e fornitori richiedono provisioning e deprovisioning sistematico, difficile da gestire con i soli strumenti nativi di AD.

Permessi per agenti AI: applicazioni e agenti che accedono a dati ed eseguono azioni per conto degli utenti richiedono un modello di autorizzazione granulare che AD non è stato progettato per gestire.

Il punto centrale non è la sostituzione, ma la modernizzazione incrementale: spostare autenticazione e controlli di accesso verso il cloud, mantenendo AD per i carichi che ne dipendono ancora, fino a quando anche quelli non vengono modernizzati o dismessi.

Entra Connect Sync vs Cloud Sync: quale scegliereIl primo bivio tecnico in ogni percorso di modernizzazione riguarda lo strumento di sincronizzazione tra AD on-premises e Microsoft Entra ID. Le due opzioni non sono intercambiabili e la scelta ha implicazioni architetturali concrete.

Microsoft Entra Connect Sync è il tool “storico”: richiede un server Windows dedicato (indicativamente 4 vCPU, 8 GB RAM, 100 GB disco) con un motore di sincronizzazione basato su SQL Server (LocalDB per ambienti piccoli, SQL Server completo oltre una certa scala). Esegue una sincronizzazione differenziale ogni 30 minuti — non è possibile scendere sotto questa soglia per limiti architetturali — e regge ambienti fino a 500.000+ oggetti. Supporta scenari che Cloud Sync non copre: Pass-through Authentication (PTA), Group Writeback per i gruppi Microsoft 365, e mapping avanzato di attributi personalizzati.

Microsoft Entra Cloud Sync è invece un agente leggero, gestito da Microsoft, installabile su un domain controller o su un server nelle vicinanze, senza alcuna dipendenza da SQL Server. Sincronizza circa ogni 2 minuti — molto più reattivo di Connect Sync — ma è limitato a circa 150.000 oggetti. Supporta solo Password Hash Sync (non PTA), non offre Group Writeback e ha opzioni di mapping attributi più limitate. In compenso offre alta disponibilità nativa tramite agenti multipli auto-ridondanti, contro la modalità staging attivo-passivo di Connect Sync che richiede failover manuale.

In sintesi: Connect Sync resta la scelta per organizzazioni grandi con requisiti di PTA o Group Writeback; Cloud Sync è preferibile per nuovi deployment con requisiti più semplici, dove la cadenza di sync più rapida e il minor carico operativo pesano più della scala massima supportata.

Privileged Identity Management: ridurre l’esposizione degli account con ruoli elevatiUno dei controlli più efficaci per ridurre la superficie d’attacco descritta da Microsoft è l’eliminazione degli account con ruoli privilegiati assegnati in modo permanente (“standing access”). Microsoft Entra Privileged Identity Management (PIM) sposta il modello verso assegnazioni eligible (idonee ma non attive) che l’utente attiva solo quando necessario, per una durata limitata e con giustificazione registrata a fini di audit.

Con Microsoft Graph PowerShell, la gestione di questo flusso è completamente scriptabile. Assegnazione di un ruolo idoneo per 10 ore:

Connect-MgGraph -Scopes "RoleManagement.ReadWrite.Directory"

$params = @{
"PrincipalId" = "d29e358a-a443-4d83-98b3-499a5405bb5b"
"RoleDefinitionId" = "88d8e3e3-8f55-4a1e-953a-9b9898b8876b"
"Justification" = "Aggiunta assegnazione idonea"
"DirectoryScopeId" = "/"
"Action" = "AdminAssign"
"ScheduleInfo" = @{
"StartDateTime" = Get-Date
"Expiration" = @{
"Type" = "AfterDuration"
"Duration" = "PT10H"
}
}
}

New-MgRoleManagementDirectoryRoleEligibilityScheduleRequest -BodyParameter $params |
Format-List Id, Status, Action, RoleDefinitionId, Justification, PrincipalIdL’utente attiva poi il ruolo solo quando serve, per un tempo limitato (qui un’ora):

$params = @{
"PrincipalId" = "d29e358a-a443-4d83-98b3-499a5405bb5b"
"RoleDefinitionId" = "88d8e3e3-8f55-4a1e-953a-9b9898b8876b"
"Justification" = "Attivazione ruolo per intervento pianificato"
"DirectoryScopeId" = "/"
"Action" = "SelfActivate"
"ScheduleInfo" = @{
"StartDateTime" = Get-Date
"Expiration" = @{
"Type" = "AfterDuration"
"Duration" = "PT1H"
}
}
}

New-MgRoleManagementDirectoryRoleAssignmentScheduleRequest -BodyParameter $paramse la disattiva esplicitamente al termine, o lascia che scada automaticamente:

$params = @{
"PrincipalId" = "d29e358a-a443-4d83-98b3-499a5405bb5b"
"RoleDefinitionId" = "88d8e3e3-8f55-4a1e-953a-9b9898b8876b"
"Justification" = "Fine intervento"
"DirectoryScopeId" = "/"
"Action" = "SelfDeactivate"
}

New-MgRoleManagementDirectoryRoleAssignmentScheduleRequest -BodyParameter $paramsIl parametro DirectoryScopeId impostato a / assegna il ruolo a livello di intero tenant; per limitare lo scope a una specifica unità amministrativa si usa un AppScopeId o lo scope dell’unità stessa. Automatizzare questi flussi via Graph PowerShell (ad esempio da una pipeline di onboarding/offboarding) è spesso più affidabile che affidarsi esclusivamente al portale, soprattutto quando serve integrare l’attivazione dei ruoli con sistemi di ticketing o approvazione esterni.

Autenticazione phishing-resistant e riduzione dei protocolli legacyLa seconda area indicata da Microsoft riguarda i metodi di autenticazione. Nella pratica, questo significa due interventi concreti su ogni tenant: primo, abilitare metodi resistenti al phishing come le chiavi di sicurezza FIDO2 o Windows Hello for Business al posto di SMS e app authenticator basate solo su OTP, che restano vulnerabili ad attacchi MFA fatigue e a proxy AiTM (adversary-in-the-middle). Secondo, disattivare progressivamente i protocolli di autenticazione legacy (Basic Auth su Exchange, POP/IMAP non moderni) che bypassano completamente la Conditional Access basata su rischio, perché non supportano la valutazione di device compliance o segnali di rischio in tempo reale.

Un percorso pragmatico per chi parte da AD puroPer chi gestisce ancora un’infrastruttura AD-centrica, l’indicazione pratica che emerge da questo cambio di approccio è di procedere per fasi, senza inseguire una migrazione big-bang:

Distribuire Entra Connect Sync o Cloud Sync (in base alla scala e ai requisiti di PTA/Group Writeback discussi sopra) per portare le identità in Entra ID mantenendo AD come source of truth.

Attivare Conditional Access basata su rischio utente e postura del dispositivo per le applicazioni cloud, riducendo la dipendenza dal solo perimetro di rete.

Migrare gli account con privilegi elevati a PIM, eliminando le assegnazioni permanenti dei ruoli critici.

Mappare quali applicazioni legacy dipendono ancora da Kerberos/NTLM puro e pianificarne la modernizzazione o l’isolamento in un segmento di rete dedicato.

Estendere la governance delle identità (lifecycle, access review periodiche) anche a utenti esterni, applicazioni registrate e, dove presenti, agenti AI con accesso a dati aziendali.

Nessuno di questi passaggi richiede di spegnere i domain controller. Il valore pratico dell’approccio ibrido è proprio questo: ridurre progressivamente la superficie d’attacco esposta dai componenti legacy, senza interrompere le applicazioni che oggi dipendono ancora da AD, fino a quando la modernizzazione di quelle stesse applicazioni non renderà possibile una dismissione più ampia.

Articolo ispirato e approfondito a partire da: Microsoft Says Active Directory Alone is No Longer Enough for Modern Identity Security, Petri IT Knowledgebase.

#sicurezza #powershell #guide #entra #azure #activedirectory

0

Caricamento...

0
1

Caricamento...

Il filesystem /proc su Linux: la guida completa per il troubleshooting da sistemista

Ogni sistemista Linux, prima o poi, si trova davanti a una domanda che top o free non riescono a risolvere del tutto: perché questo processo consuma t

Altro...

Ogni sistemista Linux, prima o poi, si trova davanti a una domanda che top o free non riescono a risolvere del tutto: perché questo processo consuma tanta memoria? Perché una porta risulta occupata ma netstat non mostra nulla? Perché un servizio continua a scrivere su un file che, in teoria, è stato cancellato? La risposta, quasi sempre, si trova in un posto che molti amministratori conoscono solo superficialmente: /proc.

/proc non è una directory come le altre. È un filesystem virtuale, di tipo procfs, generato e mantenuto interamente dal kernel in memoria: non un singolo byte dei suoi contenuti risiede su disco. È, di fatto, una finestra live sullo stato interno del kernel, esposta attraverso strumenti che ogni sistemista già conosce: cat, grep, awk. Comandi come free, ps, top e iostat non fanno altro che leggere e formattare i dati che /proc mette a disposizione: imparare a leggerlo direttamente significa avere accesso alle stesse informazioni, ma senza filtri, e con la possibilità di combinarle in modi che nessun tool preconfezionato offre.

La struttura: due mondi in una directory/proc contiene sostanzialmente due categorie di contenuti. Da un lato le directory numerate, una per ogni processo in esecuzione (/proc/1234/, dove 1234 è il PID), che espongono lo stato specifico di quel processo. Dall’altro i file di sistema globali, come /proc/meminfo o /proc/cpuinfo, che riflettono lo stato del kernel nel suo complesso, indipendentemente da quale processo li legga.

I file di sistema che contano davvero/proc/cpuinfo e /proc/stat/proc/cpuinfo elenca i core logici della CPU con modello, velocità di clock, dimensione della cache e i flag di supporto per estensioni come vmx (virtualizzazione hardware), aes e avx2. Un one-liner molto usato per contare le CPU logiche disponibili è:

grep -c '^processor' /proc/cpuinfo/proc/stat, invece, espone i contatori di tempo CPU aggregati e per singolo core, suddivisi in colonne: user, nice, system, idle, iowait, irq, softirq. Su un server sotto carico I/O-intensivo, tenere d’occhio la colonna iowait nel tempo è spesso più diagnostico di qualunque dashboard grafica, perché permette di isolare il momento esatto in cui la CPU comincia ad attendere lo storage invece di lavorare.

/proc/meminfo: oltre a “free”/proc/meminfo è la fonte dati grezza dietro al comando free, ma contiene molti più campi di quelli che free mostra normalmente. Due meritano attenzione particolare: MemAvailable, che indica la memoria realmente disponibile per nuovi processi tenendo conto della cache riclamabile (a differenza di MemFree, che è quasi sempre un numero fuorviante), e Dirty, che riporta quanta memoria contiene dati modificati ancora in attesa di essere scritti su disco — un valore che cresce pericolosamente su sistemi con storage lento e scritture intense.

Per un monitoraggio in tempo reale della pressione di memoria, questo comando è estremamente utile in fase di troubleshooting:

watch -n1 'grep -E "MemAvailable|Dirty|Writeback|SwapFree" /proc/meminfo'/proc/diskstats, /proc/loadavg, /proc/net//proc/diskstats fornisce le statistiche I/O per dispositivo — letture, scritture, settori trasferiti, tempo speso in operazioni — ed è la fonte dietro iostat. /proc/loadavg espone le tre celebri medie di carico a 1, 5 e 15 minuti, mentre /proc/uptime riporta i secondi trascorsi dal boot e il tempo cumulativo di inattività della CPU.

La sottodirectory /proc/net/ merita un capitolo a sé: /proc/net/dev contiene i contatori di byte e pacchetti per ogni interfaccia di rete, /proc/net/tcp e tcp6 elencano tutte le connessioni TCP attive in formato esadecimale, /proc/net/sockstat riassume l’utilizzo dei socket a livello di sistema, e /proc/net/snmp espone contatori SNMP utili per individuare retransmit e fallimenti di connessione anomali.

Il mondo per-processo: /proc/PID/Qui si trova la parte più preziosa per il debugging quotidiano. Alcuni file chiave:

/proc/PID/cmdline — il comando esatto con cui il processo è stato lanciato, con gli argomenti delimitati da byte null.

/proc/PID/status — un riepilogo leggibile con UID, GID, utilizzo di memoria e numero di thread. Il campo VmRSS indica la memoria residente effettivamente occupata, mentre VmSwap segnala se (e quanto) il processo è finito in swap.

/proc/PID/fd/ — una directory di symlink, uno per ogni file descriptor aperto dal processo. È la base dati su cui si appoggia lsof. Contare i descrittori aperti è semplice: ls /proc/12345/fd | wc -l.

/proc/PID/io — la contabilità I/O del processo, con read_bytes e write_bytes che riflettono i dati effettivamente passati al layer di storage.

/proc/PID/maps e /proc/PID/smaps — le regioni di memoria mappate dal processo (codice, stack, heap, librerie condivise). smaps va oltre e fornisce, per ogni regione, i dettagli su RSS, PSS e swap.

/proc/PID/environ — le variabili d’ambiente al momento del lancio, anch’esse delimitate da byte null.

/proc/PID/cwd e /proc/PID/exe — symlink rispettivamente alla directory di lavoro corrente e all’eseguibile su disco. Sono fondamentali per identificare binari che sono stati cancellati o sostituiti mentre il processo era ancora in esecuzione (un classico segnale da cercare dopo un aggiornamento di sicurezza mal gestito).

/proc/PID/oom_score e oom_score_adj — il punteggio che l’OOM killer del kernel usa per decidere quale processo terminare per primo in caso di esaurimento memoria. oom_score_adj, con un range da -1000 a 1000, permette di proteggere o “sacrificare” volontariamente un processo specifico.

Due scorciatoie tornano utili spesso: /proc/self/ punta sempre al processo che sta effettuando la lettura, mentre /proc/$$/ punta alla shell corrente all’interno di uno script.

Casi pratici di troubleshootingTrovare quale processo ha in ascolto una determinata porta (qui la porta 443/0x01BB su IPv6), senza usare ss o lsof:

inode=$(awk '$2 ~ /:01BB$/ {print $10; exit}' /proc/net/tcp6)
ls -l /proc/*/fd/ 2>/dev/null | grep "socket:[$inode]"Individuare processi che tengono aperti file già cancellati — una causa classica di dischi che risultano pieni pur senza file visibili, perché lo spazio non viene liberato finché il file descriptor resta aperto:

find /proc/*/fd -ls 2>/dev/null | grep '(deleted)'Ispezionare i contatori di interrupt per CPU, utile per diagnosticare squilibri di IRQ affinity su macchine multi-core:

cat /proc/interrupts | head -20/proc/sys e il tuning via sysctlSotto /proc/sys/ si trovano i file scrivibili che espongono i tunable del kernel — la stessa interfaccia usata da sysctl. Ad esempio, per modificare a caldo la propensione del kernel allo swap:

echo 10 | sudo tee /proc/sys/vm/swappinessTra i tunable più comuni: vm.swappiness (0-200, propensione allo swap), net.ipv4.ip_forward (abilitazione dell’IP forwarding), net.core.somaxconn (backlog massimo per i socket in ascolto) e fs.file-max (limite di file descriptor a livello di sistema). Ricordiamo che le modifiche fatte così sono volatili: per renderle permanenti serve intervenire su /etc/sysctl.conf o su un file in /etc/sysctl.d/.

/proc dentro i containerUn punto che genera spesso confusione: /proc è namespace-aware. Dentro un container Docker, la directory mostra il namespace PID del container, non quello dell’host — il PID 1 visto dall’interno è l’entrypoint del container, non l’init dell’host. Attenzione però: campi come quelli di /proc/meminfo o /proc/stat spesso riflettono ancora i totali dell’host e non i limiti imposti dai cgroup al container, un dettaglio che ha tratto in inganno più di un tool di monitoring scritto ingenuamente.

/proc contro /sys: quando usare cosa/sys (sysfs) è il filesystem virtuale complementare a /proc, ma orientato al modello dei dispositivi del kernel: driver, bus, block device, gestione dell’energia. Un esempio tipico è /sys/devices/system/cpu/cpu0/cpufreq/, che espone i parametri di scaling della frequenza per singolo core. La regola pratica: /proc per processi e stato del kernel a livello di sistema, /sys per configurazione e stato dei dispositivi hardware.

ConclusioneConoscere /proc non è un esercizio accademico: è uno degli strumenti diagnostici più potenti a disposizione di un sistemista Linux, proprio perché sta sotto ogni tool di monitoring che si finisce per usare quotidianamente. Quando top, free o netstat non bastano — o semplicemente non sono installati sulla macchina compromessa o minimale su cui ci si trova a lavorare — sapere leggere direttamente /proc/meminfo, /proc/PID/status o /proc/net/tcp fa la differenza tra un troubleshooting rapido e ore perse a indovinare. Vale la pena tenere a portata di mano, come riferimento minimo, i file /proc/meminfo, /proc/cpuinfo, /proc/stat, /proc/net/dev e la struttura di /proc/PID/: coprono la stragrande maggioranza dei casi reali di debugging su sistemi in produzione.

Fonte originale: A Guide to Linux /proc Filesystem, LinuxBlog.io

#linux #guide #howto #tutorial

1

Caricamento...

0
1

Caricamento...

PHP-FPM in produzione: perché pm static batte dynamic e come calcolare pm.max_children

Chi gestisce uno stack LEMP o LAMP in produzione conosce bene il dilemma: PHP-FPM va lasciato “respirare” con un process manager dinamico, oppure conv

Altro...

Chi gestisce uno stack LEMP o LAMP in produzione conosce bene il dilemma: PHP-FPM va lasciato “respirare” con un process manager dinamico, oppure conviene bloccare tutto su un numero fisso di worker? La risposta non è scontata, e sbagliarla ha un costo diretto in latenza durante i picchi di traffico. Vediamo perché, per molti carichi di lavoro, pm static è la scelta più solida — e come calcolare i parametri giusti senza affidarsi a numeri presi a caso da qualche post su Stack Overflow.

I tre process manager di PHP-FPMPHP-FPM gestisce i processi worker attraverso la direttiva pm nel file di pool (tipicamente /etc/php/8.x/fpm/pool.d/www.conf), che può assumere tre valori:

dynamic: il numero di processi figlio oscilla tra pm.min_spare_servers e pm.max_spare_servers, fino al tetto di pm.max_children. È il default su molte distribuzioni ed è pensato per bilanciare consumo di RAM e capacità di risposta.

ondemand: i processi vengono creati solo quando arriva una richiesta e vengono terminati dopo pm.process_idle_timeout secondi di inattività. Nessun worker “a riposo” occupa memoria, ma ogni nuovo processo comporta un fork che ha un costo in latenza.

static: il numero di worker è fissato esattamente a pm.max_children, tutti avviati all’avvio del servizio e mai terminati. Nessun fork a runtime, nessuna sorpresa.

La differenza pratica tra dynamic/ondemand e static si vede sotto carico: ogni volta che PHP-FPM deve forkare un nuovo processo per rispondere a un picco di richieste, quel fork costa tempo di CPU e, sotto pressione, può accodare le richieste in ingresso nel socket backlog. Su un server che serve traffico costante e prevedibile, questo overhead è puro spreco.

Perché “dynamic” può ingannareIl process manager dinamico sembra la scelta “intelligente” perché si adatta al carico. In realtà introduce una variabile in più proprio nei momenti in cui non la vorresti: durante un picco di traffico, quando i worker spare non bastano più, PHP-FPM deve forkarne di nuovi mentre il sistema è già sotto stress. Il risultato è un aumento di latenza percepibile negli access log, spesso confuso con un problema del database o del codice applicativo quando in realtà è il process manager stesso a introdurre il collo di bottiglia.

Quando usare pm staticLa regola pratica è semplice: se il server ha traffico sostenuto e memoria sufficiente per tenere tutti i worker sempre attivi, static è la scelta giusta. Se invece si gestiscono più pool PHP-FPM su un host condiviso con memoria limitata (tipico di ambienti multi-tenant o hosting condiviso), ondemand resta preferibile perché libera RAM quando il traffico cala.

; /etc/php/8.3/fpm/pool.d/www.conf
pm = static
pm.max_children = 40
pm.max_requests = 1000
Da notare pm.max_requests: anche in modalità static conviene non lasciarlo a 0 (illimitato). Un valore alto — 1000 richieste è un buon punto di partenza — fa sì che ogni worker venga riciclato periodicamente, mitigando eventuali memory leak nelle librerie PHP senza introdurre l’overhead di respawn continui tipico della modalità dinamica.

Come calcolare pm.max_children senza indovinareIl valore corretto di pm.max_children dipende da quanta RAM è disponibile e da quanta ne consuma mediamente un singolo worker PHP-FPM — un dato che varia moltissimo in base al framework (un’app Symfony con Doctrine pesa parecchio di più di uno script WordPress minimale).

Per misurare il consumo medio reale dei worker già in esecuzione:

ps --no-headers -o rss -C php-fpm8.3 | awk '{ sum += $1; n++ } END { print sum/n/1024 " MB" }'Questo comando interroga la RSS (Resident Set Size) di tutti i processi php-fpm attivi e ne calcola la media in MB. Con quel numero in mano, la formula diventa:

pm.max_children = (RAM dedicata a PHP-FPM in MB) / (RSS medio per worker in MB)Ad esempio, su un server con 6 GB di RAM riservati al pool PHP-FPM e worker che consumano in media 60 MB ciascuno:

6000 MB / 60 MB ≈ 100 workerÈ fondamentale non allocare a PHP-FPM tutta la RAM disponibile sulla macchina: bisogna lasciare margine per il sistema operativo, il web server (Nginx o Apache in front-end), la cache degli oggetti (Redis/Memcached) e, se presente sullo stesso host, il database. Una regola prudente è dedicare a PHP-FPM non più del 60-70% della RAM totale su un server dedicato al solo stack web.

Monitoraggio continuo, non solo calcolo una tantumIl consumo medio per worker cambia nel tempo — un deploy che introduce una libreria pesante, una query N+1 che gonfia il footprint di memoria, o semplicemente un aumento del traffico su endpoint più complessi. Vale la pena schedulare periodicamente il comando ps sopra (ad esempio via cron con output su un file di log, oppure integrandolo in un dashboard di monitoring come Netdata o Prometheus con node_exporter) per verificare che il valore di pm.max_children resti coerente con la realtà, invece di scoprirlo durante un incidente in produzione.

Un altro segnale da tenere d’occhio è il log di PHP-FPM stesso: se compaiono righe del tipo

WARNING: [pool www] server reached pm.max_children setting (40), consider raising itsignifica che il tetto è stato raggiunto e le richieste in eccesso stanno finendo in coda sul socket, con conseguente aumento del tempo di risposta. È il segnale più diretto per capire se il dimensionamento fatto a tavolino regge davvero sotto carico reale.

ConclusioneNon esiste un process manager “giusto” in assoluto: la scelta dipende dal profilo di traffico e dalla disponibilità di memoria. Ma per la maggior parte dei server di produzione con traffico prevedibile e risorse dedicate, pm static abbinato a un pm.max_children calcolato sul consumo reale di RSS — e non copiato da un tutorial generico — elimina una fonte di latenza spesso invisibile finché non arriva il picco di traffico che la rende evidente. Vale la pena rivedere la configurazione dei propri pool PHP-FPM con questo approccio, misurando prima di decidere.

Fonte: LinuxBlog.io — PHP-FPM tuning: Using ‘pm static’ for max performance

#linux #guide #howto #tutorial #performance #php

0

Caricamento...

0
1

Caricamento...

Entra ID: l’operatore MemberOf va in pensione il 3 novembre 2026, ecco come prepararsi

Chi amministra Microsoft ID conosce bene il problema dei “gruppi nidificati”: per anni non è stato pos

Altro...

Chi amministra Microsoft ID conosce bene il problema dei “gruppi nidificati”: per anni non è stato possibile costruire un gruppo dinamico che includesse automaticamente i membri di un altro gruppo. La regola preview memberOf, introdotta proprio per colmare questa lacuna, sta però per essere ritirata. Dal 3 novembre 2026 tutte le configurazioni che la usano smetteranno di aggiornarsi, restando congelate all’ultimo stato elaborato correttamente. Se gestite gruppi dinamici, unità amministrative dinamiche o policy di entitlement management basate su memberOf, è il momento di pianificare la migrazione.

Cos’è (stato) l’operatore memberOfIn anteprima pubblica, memberOf ha permesso di creare gruppi a membership dinamica popolati a partire dall’appartenenza ad altri gruppi, di sicurezza, Microsoft 365 o sincronizzati da Active Directory on-premises. La regola si scriveva nella sintassi avanzata del rule editor, non essendo mai stata supportata dal rule builder grafico:

// Regola per un gruppo dinamico di utenti
user.memberof -any (group.objectId -in ['<groupObjectId>'])

// Regola per un gruppo dinamico di device
device.memberof -any (group.objectId -in ['<groupObjectId>'])

// Più gruppi sorgente contemporaneamente
user.memberof -any (group.objectId -in ['<groupObjectId1>', '<groupObjectId2>'])Era possibile usarla per gruppi dinamici veri e propri, per unità amministrative dinamiche e per policy di auto-assignment in Entra ID Governance, con limiti già stringenti in preview: 500 gruppi memberOf per tenant, massimo 50 gruppi sorgente per regola, nessuna combinazione con altri operatori o con altre regole memberOf annidate.

Perché Microsoft la ritiraDurante la preview, Microsoft ha osservato che l’uso di memberOf può rallentare l’elaborazione della membership dinamica per tutti i gruppi del tenant, non solo per quelli che la utilizzano: un singolo gruppo configurato con questo operatore può introdurre ritardi di elaborazione a livello di tenant. Per questo motivo Microsoft ha deciso di ritirare l’operatore dalla preview, pur riconoscendo la validità dello scenario d’uso, e sta sviluppando una soluzione alternativa più scalabile, senza però fornire ancora una data di disponibilità.

Cosa succede dopo il 3 novembre 2026Le configurazioni che usano ancora memberOf non genereranno errori visibili: semplicemente smetteranno di aggiungere o rimuovere membri quando cambia l’appartenenza ai gruppi sorgente, restando congelate all’ultimo stato noto. È un comportamento subdolo perché non c’è un evento di rottura evidente, solo un progressivo disallineamento tra la realtà organizzativa e ciò che Entra ID applica. Gli effetti possono includere:

Accessi Teams e SharePoint non più aggiornati per utenti entrati o usciti da un gruppo sorgente

Targeting delle policy di Conditional Access basato su appartenenze obsolete

Licenze assegnate tramite group-based licensing non più coerenti con l’organico reale

Ambiti amministrativi (administrative unit) che non riflettono più la struttura corrente

Assegnazioni di access package in Entra ID Governance bloccate sullo stato congelato

Come prepararsi: audit prima della deadlineIl primo passo è mappare ogni configurazione che dipende da memberOf. Per i gruppi dinamici, si può esportare l’elenco dall’Entra admin center oppure interrogare Microsoft Graph cercando la stringa nella proprietà MembershipRule:

Connect-MgGraph -Scopes "Group.Read.All"

Get-MgGroup -All -Filter "groupTypes/any(c:c eq 'DynamicMembership')" `
-Property Id, DisplayName, MembershipRule |
Where-Object { $_.MembershipRule -match 'memberof' } |
Select-Object Id, DisplayName, MembershipRulePer le unità amministrative dinamiche e le policy di auto-assignment dell’entitlement management non esiste (ancora) un filtro diretto lato server sulla regola: occorre enumerare gli oggetti e verificare la proprietà della regola dinamica, ad esempio:

Unità amministrative dinamiche

Get-MgDirectoryAdministrativeUnit -All -Property Id, DisplayName, MembershipRule |
Where-Object { $_.MembershipRule -match 'memberof' }

Policy di auto-assignment (Entitlement Management)

Get-MgEntitlementManagementAccessPackageAssignmentPolicy -All |
Where-Object { $_.AutomaticRequestSettings.RequestAccessForAllowedTargets -ne $null }Per le policy di entitlement management è comunque consigliabile incrociare l’output con la revisione manuale in Entra ID Governance, dato che la struttura della regola può variare a seconda di come è stata configurata.

Strategie di migrazioneUna volta identificate le configurazioni a rischio, Microsoft indica due strade principali:

Sostituire la regola con operatori dinamici supportati (ad esempio basati su attributi utente o dispositivo), quando esiste un equivalente funzionale

Convertire a membership assegnata quando non è possibile replicare la logica di nesting con le regole standard, accettando la gestione manuale o tramite automazione esterna (es. script PowerShell schedulati o Logic App)

In entrambi i casi, prima di considerare chiusa la migrazione bisogna validare concretamente: verificare che la membership finale del gruppo coincida con quella attesa, controllare che le assegnazioni di licenza, gli scope di Conditional Access e i pacchetti di accesso continuino a comportarsi correttamente, ed eliminare le configurazioni ormai inutilizzate invece di lasciarle come debito tecnico silente.

ConclusioneIl ritiro di memberOf è un promemoria di un principio più generale nel amministrato: le funzionalità in preview non vanno mai considerate stabili in produzione, per quanto risolvano un problema reale. Con circa tre mesi di margine dalla data di scrittura di questo articolo al 3 novembre 2026, il momento giusto per l’audit è ora, prima che il “congelamento” silenzioso della membership diventi un problema di accesso scoperto in produzione da un utente che segnala di aver perso l’accesso a un canale Teams.

Fonte: Microsoft Learn – Configure dynamic membership groups with the memberOf operator, con approfondimenti da 4sysops e Petri IT Knowledgebase.

#microsoft #powershell #guide #entra #azure

0

Caricamento...

0
1

Caricamento...