Vai al contenuto principale

#tlsssl

Let’s Encrypt: dal 2027 i certificati passano da 90 a 64 giorni (e poi a 45 nel 2028)

Il 10 febbraio 2027 Let’s Encrypt cambierà la durata predefinita dei certificati TLS da 90 a 64 giorni. Non è un capriccio: è il passo successivo di u

Altro...

Il 10 febbraio 2027 Let’s Encrypt cambierà la durata predefinita dei certificati TLS da 90 a 64 giorni. Non è un capriccio: è il passo successivo di una roadmap annunciata da tempo, che punta a portare la validità dei certificati pubblici fino a 45 giorni nel 2028, in linea con i nuovi requisiti del CA/#Browser Forum che vincolano ormai tutte le Certification Authority pubbliche. Per chi gestisce infrastrutture , VPN, API gateway o semplicemente un parco server con certificati emessi da Let’s Encrypt, il cambiamento tocca in pieno l’automazione del rinnovo: gli script con intervalli “hardcoded” di 60 o 80 giorni, ancora comuni in molti ambienti, smetteranno di funzionare correttamente.

Il calendario del cambiamentoLet’s Encrypt ha pubblicato un calendario preciso, con un periodo di test prima di ogni passaggio in produzione:

13 maggio 2026 — il profilo ACME tlsserver passa già a certificati da 45 giorni, in modalità opt-in per chi vuole anticipare i tempi.

14 ottobre 2026 — i certificati da 64 giorni iniziano a essere emessi nell’ambiente di staging, per permettere ai gestori di infrastrutture di testare l’impatto prima del rilascio in produzione.

10 febbraio 2027 — il profilo predefinito classic passa a 64 giorni di validità, con un periodo di riutilizzo ’autorizzazione (authorization reuse) ridotto da 30 a 10 giorni.

11 maggio 2027 — data prevista in cui l’ultimo certificato da 90 giorni emesso prima del cambio scadrà naturalmente.

16 febbraio 2028 — il profilo classic passa a 45 giorni, con riutilizzo dell’autorizzazione ridotto a sole 7 ore.

2029 — ulteriore riduzione dei periodi massimi di riutilizzo della validazione.

I certificati già emessi mantengono la loro scadenza originale: il cambiamento si applica solo alle nuove emissioni e ai rinnovi effettuati dopo ciascuna data. Rate limit, endpoint ACME e catene di emissione restano invariati.

Perché Let’s Encrypt accorcia la validitàLa motivazione dichiarata è ridurre la finestra di esposizione in caso di compromissione della chiave privata o di mis-issuance, e rendere più efficienti i meccanismi di revoca. Con certificati che vivono poche settimane, un certificato compromesso o emesso per errore ha un impatto temporale molto più limitato rispetto a uno valido novanta giorni — anche quando la revoca esplicita è lenta o non avviene affatto, perché il certificato scade comunque in fretta. È la stessa logica da anni dietro il progressivo accorciamento dei certificati nel settore: dai 3 anni di un tempo, ai 2, a 1, fino ai 90 giorni introdotti da Let’s Encrypt stessa nel 2015 come standard de facto del web pubblico.

Il profilo giusto per ogni esigenzaLet’s Encrypt offre oggi tre profili selezionabili lato client ACME:

classic — il profilo predefinito, oggetto del cambiamento: 90 giorni oggi, 64 da febbraio 2027, 45 dal 2028.

tlsserver — già a 45 giorni dal maggio 2026, pensato per chi vuole adottare in anticipo le validità più brevi.

shortlived — certificati da appena 6 giorni, per scenari ad altissima automazione dove la rotazione continua è parte integrante del modello di sicurezza (ad esempio ambienti -native con emissione automatizzata a ogni deploy).

Il profilo si imposta nella configurazione del client ACME (certbot, acme.sh, , win-acme e simili supportano o stanno aggiungendo il parametro), non lato o lato server web.

ARI: lasciate che sia Let’s Encrypt a dirvi quando rinnovareIl meccanismo chiave per affrontare senza stress l’accorciamento della validità è ARI (ACME Renewal Information): un’estensione del protocollo ACME con cui Let’s Encrypt comunica direttamente al client la finestra ottimale di rinnovo per ogni singolo certificato, invece di lasciare che sia lo script a calcolarla con una soglia fissa. I client che implementano ARI (certbot dalla versione 2.9, e la maggior parte dei client moderni) non richiedono alcuna modifica: continueranno a rinnovare al momento giusto anche quando la validità scenderà a 64 e poi a 45 giorni. Vale comunque la pena verificare nella documentazione del proprio client che il supporto ARI sia effettivamente abilitato, non solo disponibile.

Checklist operativa per prepararsiPer chi gestisce certificati Let’s Encrypt in produzione, questi sono i passaggi concreti da affrontare prima di febbraio 2027:

Verificare il supporto ARI del proprio client ACME (certbot, acme.sh, Caddy, Traefik, cert-manager su , ecc.) e assicurarsi che sia attivo.

Testare in staging a partire dal 14 ottobre 2026, puntando il client all’ambiente di staging di Let’s Encrypt per verificare che il rinnovo a 64 giorni funzioni correttamente nella propria pipeline.

Cercare valori hardcoded in cron job, wrapper script e runbook: soglie fisse come 83, 80 o 60 giorni vanno sostituite con la logica “rinnova a due terzi della validità” (per un certificato da 64 giorni, circa al giorno 43, con un margine di circa 21 giorni) oppure, meglio ancora, delegate ad ARI.

Automatizzare reload e deploy del certificato rinnovato: con rinnovi più frequenti, un passaggio manuale dimenticato diventa un problema molto più probabile.

Aggiungere alerting sui fallimenti di rinnovo, non solo sulla scadenza imminente: con cicli di 64 o 45 giorni, un fallimento silenzioso lascia meno tempo di reazione.

Uno sguardo oltre il 2027: DNS-PERSIST-01Parallelamente alla riduzione delle validità, è in fase di standardizzazione presso CA/Browser Forum e IETF un nuovo metodo di validazione chiamato DNS-PERSIST-01, atteso nel 2026. L’idea è che il record TXT usato per la validazione del dominio non debba essere aggiornato a ogni rinnovo: lo si imposta una sola volta, riducendo la dipendenza dall’automazione DNS e dal riutilizzo dell’autorizzazione che, come visto, si sta progressivamente accorciando. È un tassello pensato proprio per rendere sostenibili rinnovi sempre più frequenti anche per chi la validazione DNS-01 in ambienti con DNS gestito manualmente o con permessi ristretti.

ConclusioneIl passaggio da 90 a 64 giorni non è un’emergenza da gestire in extremis, ma nemmeno un dettaglio da ignorare: chi ha automatizzato correttamente il rinnovo con un client ACME moderno e supporto ARI probabilmente non dovrà toccare nulla. Chi invece ha script scritti anni fa con soglie fisse, o processi di rinnovo semi-manuali, ha una finestra di oltre un anno — da oggi a febbraio 2027 — per testare in staging, ripulire l’automazione e abilitare l’alerting. Vista la direzione dichiarata verso i 45 giorni nel 2028 e oltre, è un lavoro che conviene comunque fare ora: i cicli di vita dei certificati pubblici continueranno ad accorciarsi.
Fonte: Let’s Encrypt – 64-day certs e ISRG – From 90 to 45.

#sicurezza #howto #tutorial #tlsssl #letsencrypt

0

Caricamento...

0
1

Caricamento...

Ottimizzare TLS in Nginx: come ridurre TTFB e latenza HTTPS

Ottimizzare il livello applicativo, il database e la cache è il modo più efficace per abbassare il Time To First Byte (TTFB) di un sito servito via HT

Altro...

Ottimizzare il livello applicativo, il database e la cache è il modo più efficace per abbassare il Time To First Byte (TTFB) di un sito servito via HTTPS. Ma c’è un secondo livello, spesso trascurato, dove si possono recuperare decine di millisecondi su ogni singola richiesta a costo zero: la configurazione TLS di . Handshake lenti, sessioni non riutilizzate e direttive obsolete aggiungono overhead a ogni connessione, soprattutto per i client che non riescono a sfruttare il riutilizzo di sessione. Vediamo come intervenire in modo concreto, direttiva per direttiva.

HTTP/2 e HTTP/3: le basi sono cambiateSe la vostra configurazione Nginx ancora listen 443 ssl http2;, è il momento di aggiornarla: dalla versione 1.25.1 la sintassi combinata è deprecata a favore di una direttiva separata:

listen 443 ssl;
http2 on;Dalla 1.25.0, inoltre, il supporto nativo a QUIC/HTTP3 è incluso nel ramo mainline, senza bisogno di al sorgente o build custom. Per abilitarlo:

listen 443 quic reuseport;
listen [::]:443 quic reuseport;
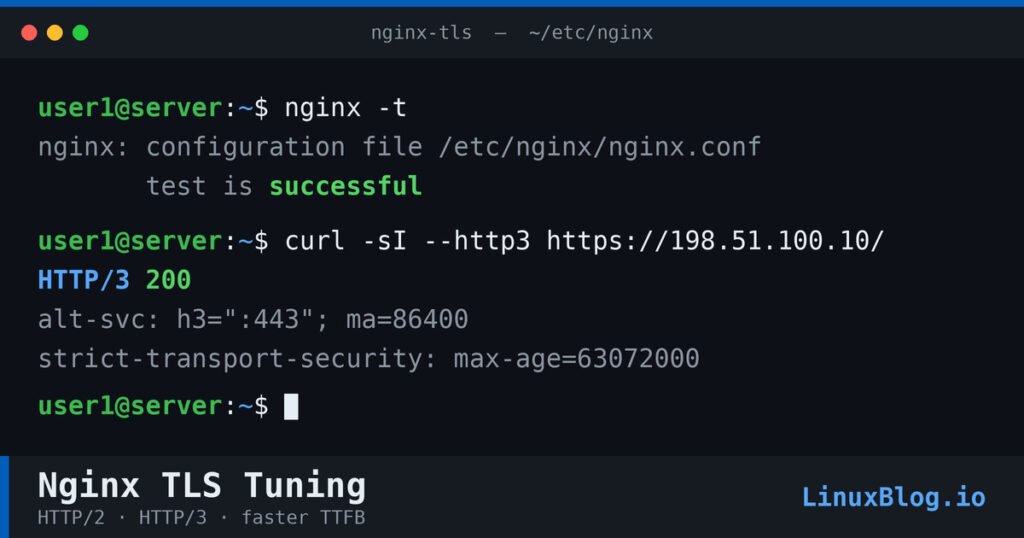
add_header Alt-Svc 'h3=":443"; ma=86400';Un paio di dettagli che fanno la differenza: la direttiva reuseport va dichiarata una sola volta per IP e porta (sugli altri server block si usa semplicemente listen 443 quic;), e senza l’header Alt-Svc i non hanno modo di scoprire che il server supporta HTTP/3, quindi continueranno a usare HTTP/2. Per verificare che tutto funzioni:

curl --http2 -I https://dominio.it/
curl --http3 -I https://dominio.it/Session cache e session ticket: evitare l’handshake completoOgni handshake TLS completo costa round trip e calcolo crittografico. Riutilizzare una sessione già stabilita li elimina quasi del tutto. La cache condivisa va dimensionata in base al traffico: circa 4.000 sessioni per ogni MB allocato.

ssl_session_cache shared:SSL:10m;
ssl_session_timeout 1d;
ssl_session_tickets on;Un chiarimento importante per chi segue guide datate: per anni la raccomandazione standard è stata disabilitare i session ticket (ssl_session_tickets off;) per motivi di forward secrecy, perché la gestione delle chiavi di cifratura dei ticket era debole. Da Nginx 1.23.2 in poi la gestione è stata irrobustita in modo sostanziale, e oggi la raccomandazione è lasciarli attivi — a meno che non si gestisca un cluster di server dietro load balancer che non condividono e ruotano le chiavi dei ticket tra loro, nel qual caso vanno disattivati o la rotazione va implementata esplicitamente.

Versioni del protocollo: fuori TLS 1.0 e 1.1TLS 1.0 e 1.1 sono obsoleti, vulnerabili a classi di attacchi note e esplicitamente vietati dallo standard PCI DSS per chi gestisce pagamenti. Per un sito pubblico generico:

ssl_protocols TLSv1.2 TLSv1.3;Se invece controllate anche i client che si connettono (API interne, , mobile app proprietarie), potete spingervi oltre:

ssl_protocols TLSv1.3;TLS 1.3, disponibile da Nginx 1.13, completa l’handshake in un solo round trip (contro i due di TLS 1.2) e supporta nativamente la ripresa di sessione: è probabilmente la singola modifica con il miglior rapporto tra impatto sulla latenza e sforzo di configurazione.

OCSP stapling: una direttiva da rivedere, non da copiare e incollareLa configurazione “classica” per l’OCSP stapling è questa:

ssl_stapling on;
ssl_stapling_verify on;
ssl_trusted_certificate /path/to/full_chain.pem;
resolver 8.8.8.8 8.8.4.4 valid=300s;
resolver_timeout 5s;Ma se i vostri certificati sono emessi da Let’s Encrypt, queste direttive oggi non fanno più nulla: Let’s Encrypt ha spento i propri responder OCSP il 6 agosto 2025, e i certificati emessi successivamente non contengono più un URL OCSP. Nginx, di conseguenza, si limita a loggare "ssl_stapling" ignored, no OCSP responder URL a ogni reload. Se usate solo certificati Let’s Encrypt potete rimuovere queste righe senza perdere nulla; se la vostra CA pubblica ancora un URL OCSP, mantenerle resta un piccolo beneficio per i client che verificano la revoca in questo modo.

Buffer size: un dettaglio che si senteIl buffer di invio TLS di Nginx è impostato di default a 16k. Ridurlo a 4k può diminuire il TTFB percepito, perché i dati iniziano a essere trasmessi prima invece di attendere il riempimento del buffer:

ssl_buffer_size 4k;Il guadagno tipico misurato è nell’ordine di 30-50 ms, ma varia sensibilmente in base al profilo del traffico e alla dimensione media delle risposte: su payload molto grandi un buffer più piccolo introduce più overhead per via del maggior numero di record TLS, quindi vale la pena misurare prima e dopo sul proprio traffico reale.

Cipher suite e configurazione completaUn esempio di configurazione aggiornata che mette insieme i punti precedenti:

http2 on;
ssl_protocols TLSv1.2 TLSv1.3;
ssl_prefer_server_ciphers off;
ssl_ciphers 'ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305';
ssl_session_cache shared:SSL:10m;
ssl_session_timeout 1d;
ssl_session_tickets on;
ssl_buffer_size 4k;Due note su questo blocco: ssl_ciphers influisce solo su TLS 1.2, perché le suite di TLS 1.3 sono fissate dallo standard e non configurabili; e ssl_prefer_server_ciphers off è corretto nel 2026, perché sono ormai i client moderni a scegliere le suite più sicure, non il server. Per generare una configurazione aggiornata in base al proprio parco client supportato (moderno, intermedio, compatibilità estesa), conviene affidarsi al Mozilla SSL Configuration Generator invece di mantenere a mano liste di cipher. Prima di ricaricare in produzione, testate sempre la sintassi:

nginx -t
nginx -s reloadHeader di sicurezza correlatiDue direttive da affiancare alla configurazione TLS, perché riguardano la stessa superficie di sicurezza:

add_header Strict-Transport-Security "max-age=63072000; includeSubdomains; preload";
add_header X-Frame-Options sameorigin;
add_header X-Content-Type-Options nosniff;Da evitare invece l’header X-XSS-Protection, ormai ignorato da tutti i browser moderni che ne hanno rimosso il motore di auditing XSS: la protezione va implementata con una Content-Security-Policy ben definita, non con quell’header legacy.

Quanto incide davvero sul TTFBVa detto con chiarezza: il tuning TLS riduce l’overhead ’handshake e migliora il riutilizzo delle connessioni, ma non risolve un’applicazione lenta. Se il TTFB è dominato da query al database non ottimizzate, cache assente o backend sovraccarico, questi interventi si misurano in decine di millisecondi, mentre i problemi applicativi si misurano in centinaia o migliaia. Il tuning TLS va quindi visto come un passaggio di hardening e ottimizzazione a basso sforzo da fare una volta per tutte, non come sostituto dell’ottimizzazione di , query e configurazione del backend.

ConclusioneAggiornare la direttiva HTTP/2, valutare HTTP/3, lasciare attivi i session ticket moderni, eliminare TLS 1.0/1.1, rimuovere lo stapling OCSP inutile su certificati Let’s Encrypt e ridurre il buffer size sono interventi che si implementano in pochi minuti e si verificano subito con nginx -t e un test con curl. Non sostituiscono il lavoro di ottimizzazione lato applicazione, ma su un sito già ben ottimizzato a monte sono spesso il margine che separa un TTFB discreto da uno davvero competitivo.

Fonte: LinuxBlog.io – Nginx tuning tips: HTTPS/TLS – Turbocharge TTFB/Latency.

#linux #howto #tutorial #performance #nginx #tlsssl

0

Caricamento...

0
1

Caricamento...

Nginx e TLS: come ridurre TTFB e latenza con le impostazioni giuste

Il TTFB non dipende solo dall’applicazione: quanto costa davvero l’handshake TLSQuando un sito HTTPS risponde lentamente, il riflesso condizionato di

Altro...

Il TTFB non dipende solo dall’applicazione: quanto costa davvero l’handshake TLSQuando un sito HTTPS risponde lentamente, il riflesso condizionato di ogni sistemista è guardare al backend: query lente, cache assente, un’applicazione PHP o .NET che non scala. Ma prima ancora che la richiesta arrivi al codice applicativo, il client e il server devono completare un handshake TLS, negoziare un protocollo, verificare un certificato ed eventualmente riprendere una sessione precedente. Ognuno di questi passaggi ha un costo in millisecondi, e su siti ad alto traffico o con molte connessioni “fredde” (nuovi visitatori, CDN edge miss, mobile su rete instabile) quel costo si somma in modo tutt’altro che trascurabile.

La buona notizia è che gran parte di questo overhead è governato da una manciata di direttive Nginx che, se lasciate ai valori di default, non sono ottimizzate per la latenza. In questo articolo vediamo come intervenire in modo mirato su HTTP/2, HTTP/3, cache di sessione TLS, versioni del protocollo, cipher suite e OCSP stapling, con un occhio a cosa è davvero cambiato nel panorama TLS nel 2026 rispetto a configurazioni “storiche” che circolano ancora in molte guide.

HTTP/2 e HTTP/3: come attivarli correttamenteSu Nginx recente (1.25.1 e successivi) il supporto HTTP/2 non si attiva più come parametro del blocco listen, ma con una direttiva dedicata. La sintassi legacy listen 443 ssl http2; è deprecata e in alcune build genera un warning in fase di reload:

listen 443 ssl;
http2 on;Per chi vuole spingersi oltre, HTTP/3 (basato su QUIC, quindi su UDP anziché TCP) è supportato nativamente da Nginx 1.25.0 in poi:

listen 443 ssl;
listen [::]:443 ssl;
listen 443 quic reuseport;
listen [::]:443 quic reuseport;
http2 on;
add_header Alt-Svc 'h3=":443"; ma=86400';L’header Alt-Svc non è opzionale: senza di esso il browser non ha modo di sapere che il server parla anche HTTP/3, e continuerà a usare HTTP/2 anche se QUIC è configurato correttamente sul lato server. Va inoltre ricordato che molte reti aziendali e alcuni provider filtrano il traffico UDP sulla porta 443, quindi HTTP/3 va sempre trattato come miglioramento progressivo e non come sostituto esclusivo di HTTP/2.

Session cache e session ticket: evitare handshake completiOgni handshake TLS completo comporta uno scambio di chiavi asimmetrico, che è l’operazione più costosa dell’intero processo. La cache di sessione permette a un client che si riconnette di saltare questo passaggio:

ssl_session_cache shared:SSL:10m;
ssl_session_timeout 1d;
ssl_session_tickets on;Una cache condivisa da 10 MB memorizza circa 4.000 sessioni: per un sito a traffico medio è più che sufficiente, ma su cluster con più worker o più nodi Nginx dietro un load balancer va dimensionata in base al numero di client unici attesi nella finestra di ssl_session_timeout. Un dettaglio spesso trascurato: da Nginx 1.23.2 la gestione delle chiavi dei session ticket è stata migliorata, ma se si opera un’infrastruttura con più server dietro lo stesso load balancer, le chiavi di ticket vanno sincronizzate tra i nodi (tipicamente con ssl_session_ticket_key e un file condiviso via configuration management), altrimenti il beneficio della ripresa di sessione si perde ogni volta che il client finisce su un nodo diverso da quello dell’handshake iniziale.

Versioni del protocollo: perché TLS 1.3 non è solo “più sicuro”La direttiva sulle versioni supportate resta relativamente semplice:

ssl_protocols TLSv1.2 TLSv1.3;Il punto tecnico interessante è che TLS 1.3 non porta solo benefici di sicurezza (rimozione di cipher obsoleti, forward secrecy obbligatoria), ma anche di performance pura: riduce l’handshake a un singolo round trip contro i due richiesti da TLS 1.2, e supporta la ripresa di sessione tramite un meccanismo (0-RTT/PSK) che rende le riconnessioni ancora più rapide. Per un client con RTT di rete di 80-100ms verso il server — scenario comune per utenti mobile o geograficamente distanti dal datacenter — il risparmio di un intero round trip si traduce direttamente in TTFB più basso.

Mantenere TLS 1.2 come fallback resta comunque prudente per compatibilità con client legacy (alcune librerie HTTP embedded, dispositivi IoT, versioni datate di Android). Limitarsi al solo TLS 1.3 va considerato solo per ambienti controllati, come API interne o servizi machine-to-machine dove si conoscono con certezza i client.

Cipher suite: meno è meglio, con TLS 1.3Su TLS 1.2 la scelta delle cipher suite ha ancora impatto pratico:

ssl_prefer_server_ciphers off;
ssl_ciphers 'ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305';Da notare l’impostazione ssl_prefer_server_ciphers off: con TLS 1.3 e i client moderni, lasciare che sia il client a scegliere la cipher (in base a cosa è accelerato via hardware sul suo dispositivo, ad esempio AES-NI vs ChaCha20 su mobile) è generalmente più efficiente che imporre l’ordine lato server.

Con TLS 1.3, però, le cipher suite sono fissate dal protocollo stesso: mantenere una lunga stringa ssl_ciphers personalizzata e una direttiva ssl_ecdh_curve manuale non porta quasi nessun beneficio aggiuntivo per le connessioni che negoziano TLS 1.3, e serve solo a coprire il fallback su TLS 1.2. Molte configurazioni “best practice” che circolano online sono più complesse del necessario proprio perché non tengono conto di questo aspetto.

OCSP stapling: un capitolo da riscrivere nel 2026Fino a poco tempo fa, l’OCSP stapling era una delle ottimizzazioni TLS più raccomandate: invece di far verificare al browser lo stato di revoca del certificato con una richiesta separata al CA, il server allega (“stapla”) una risposta OCSP firmata direttamente durante l’handshake, risparmiando un round trip:

ssl_stapling on;
ssl_stapling_verify on;
ssl_trusted_certificate /path/to/full_chain.pem;
resolver 8.8.8.8 8.8.4.4 valid=300s;
resolver_timeout 5s;Questo è un punto su cui molti sistemisti non sono ancora allineati: Let’s Encrypt ha dismesso il supporto OCSP nell’agosto 2025, passando esclusivamente a CRL (Certificate Revocation List) a corto ciclo di vita per la verifica di revoca. Se i certificati del vostro dominio provengono da Let’s Encrypt, le direttive sopra sono di fatto inerti: Nginx proverà a fare stapling ma non otterrà risposte valide, e conviene rimuoverle per tenere la configurazione pulita e i log privi di errori di risoluzione OCSP inutili. Se invece usate un CA diverso che continua a supportare OCSP, le direttive restano valide e utili.

Buffer TLS: un’ottimizzazione minore ma misurabilessl_buffer_size 4k;Il valore di default di Nginx per il buffer di invio TLS è 16k, pensato per massimizzare il throughput su trasferimenti di grandi dimensioni. Per il traffico HTTP tipico — pagine HTML, chiamate API, asset di dimensioni moderate — un buffer più piccolo (4k) riduce la quantità di dati che devono essere cifrati e trasmessi prima che il client possa iniziare a processare la risposta, con un guadagno tipico nell’ordine di 30-50ms sul TTFB. È un’ottimizzazione minore rispetto a HTTP/2 o al session caching, ma essendo a costo zero (nessun trade-off di sicurezza) vale la pena applicarla su siti dove il TTFB è una metrica critica.

Configurazione completa di riferimentoserver {
listen 443 ssl;
listen [::]:443 ssl;
http2 on;

ssl_certificate     /etc/nginx/ssl/fullchain.pem;
ssl_certificate_key /etc/nginx/ssl/privkey.pem;

ssl_protocols TLSv1.2 TLSv1.3;
ssl_prefer_server_ciphers off;
ssl_ciphers 'ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305';

ssl_session_cache shared:SSL:10m;
ssl_session_timeout 1d;
ssl_session_tickets on;
ssl_buffer_size 4k;

add_header Strict-Transport-Security "max-age=63072000; includeSubdomains; preload" always;
add_header X-Frame-Options SAMEORIGIN always;
add_header X-Content-Type-Options nosniff always;

}Da personalizzare rimuovendo il blocco OCSP se il certificato proviene da Let’s Encrypt, e aggiungendo i blocchi listen ... quic reuseport; e l’header Alt-Svc se si vuole abilitare anche HTTP/3.

Cosa aspettarsi (e cosa no) da questa ottimizzazioneVale la pena essere chiari sui limiti: il tuning TLS non risolve un’applicazione lenta. Se il backend impiega 800ms per generare una risposta, risparmiare 50ms sull’handshake è un’ottimizzazione marginale rispetto al problema reale. Dove il tuning TLS fa davvero la differenza è nel ridurre l’overhead fisso presente su ogni richiesta HTTPS, in particolare per le connessioni “fredde” e per utenti con RTT di rete elevato — scenari in cui il costo dell’handshake può facilmente superare il tempo di elaborazione lato server. Caching applicativo, ottimizzazione del backend e CDN restano le leve principali per le performance complessive, ma un livello TLS ben configurato è la base su cui tutte le altre ottimizzazioni si appoggiano, ed è spesso trascurata proprio perché “funziona già” con i valori di default.

Articolo ispirato e approfondito a partire da: Nginx tuning tips: HTTPS/TLS – Turbocharge TTFB/Latency, LinuxBlog.io.

#howto #tutorial #nginx #tlsssl

0

Caricamento...

0
1

Caricamento...

Nginx e TLS nel 2026: le tecniche aggiornate per ridurre TTFB e latenza HTTPS

Nel 2026 quasi tutto il traffico web viaggia in HTTPS, ma quanto di quella cifratura sta ancora costando millisecondi inutili al vostro Time To First

Altro...

Nel 2026 quasi tutto il traffico web viaggia in HTTPS, ma quanto di quella cifratura sta ancora costando millisecondi inutili al vostro Time To First Byte? Molte configurazioni Nginx che giravano perfettamente nel 2020 oggi trascinano direttive deprecate, parametri OCSP che non fanno più nulla e cipher suite che TLS 1.3 ignora comunque. Vale la pena rimettere mano al blocco ssl_* del vostro server, non per inseguire un punteggio più alto su SSL Labs, ma perché ogni handshake più corto si moltiplica per il numero di visitatori.

Va detto subito, con onestà: il tuning TLS non salva un backend lento. Se il TTFB del vostro sito è dominato da query al database, cache fredda o un’applicazione PHP/.NET che impiega 800ms a costruire la pagina, ottimizzare l’handshake sposta l’ago di qualche decina di millisecondi. Ma è ottimizzazione a costo quasi zero, che si somma a tutto il resto: cache, CDN, query tuning. Va fatta bene una volta e poi dimenticata.

HTTP/2 e HTTP/3: la sintassi è cambiataSe la vostra configurazione risale a qualche anno fa, probabilmente avete ancora questa riga:

listen 443 ssl http2;Funziona ancora, ma da Nginx 1.25.1 il parametro http2 sulla direttiva listen è deprecato: lanciando nginx -t su una build recente comparirà un warning esplicito. La forma corretta separa i due concetti:

listen 443 ssl;
http2 on;La direttiva http2 attiva il protocollo per l’intero server block, il che è più pulito che ripeterlo su ogni riga listen. Se gestite una flotta di server dietro un load balancer, verificate che tutte le istanze montino Nginx 1.25.1 o superiore prima di effettuare lo switch: una versione più vecchia non riconosce http2 on; e si rifiuta di avviarsi.

Attivare HTTP/3 con QUIC senza compilare nullaFino a poco tempo fa, abilitare HTTP/3 su Nginx significava patchare e ricompilare da sorgente contro una libreria TLS con supporto QUIC: un esercizio che pochi sistemisti volevano affrontare in produzione. Quell’epoca è finita. Il supporto nativo a QUIC e HTTP/3 è arrivato nel mainline Nginx a partire dalla 1.25.0 ed è ormai maturo nel branch stable, quindi sulle distribuzioni recenti o sul repository ufficiale Nginx non serve più compilare nulla a mano.

Va detto che, nonostante l’entusiasmo degli anni scorsi, l’adozione reale di HTTP/3 procede più lentamente del previsto: a metà 2026 HTTP/2 serve poco più della metà delle richieste globali mentre HTTP/3 si attesta intorno al 21%, con un plateau che dura da diversi mesi. Parte del motivo è strutturale: un browser passa a HTTP/3 solo dopo aver scoperto il supporto tramite un header Alt-Svc o un record DNS, quindi molte prime visite non negoziano mai QUIC. Vale comunque la pena abilitarlo: sposta il trasporto su UDP ed elimina l’head-of-line blocking di TCP, un vantaggio concreto su connessioni mobili lente o con perdita di pacchetti.

Su Nginx 1.25.0 o superiore con supporto QUIC integrato, un server block tipico è:

server {
listen 443 ssl;
listen [::]:443 ssl;
listen 443 quic reuseport;
listen [::]:443 quic reuseport;

http2 on;

ssl_certificate     /path/to/your/certificate.pem;
ssl_certificate_key /path/to/your/key.pem;

# Annuncia HTTP/3 ai client che arrivano via HTTP/1.1 o HTTP/2
add_header Alt-Svc 'h3=":443"; ma=86400';

# ... resto della configurazione del server

}Attenzione a reuseport: va specificato una sola volta per combinazione IP/porta. Se gestite più server block sullo stesso indirizzo, mettete reuseport solo sul blocco predefinito e usate listen 443 quic; sugli altri, altrimenti Nginx si rifiuta di partire.

L’header Alt-Svc è il dettaglio che quasi tutti dimenticano: senza di esso i browser non hanno modo di sapere che il server parla HTTP/3 e restano su HTTP/2. Dopo la modifica, testate e ricaricate:

nginx -t
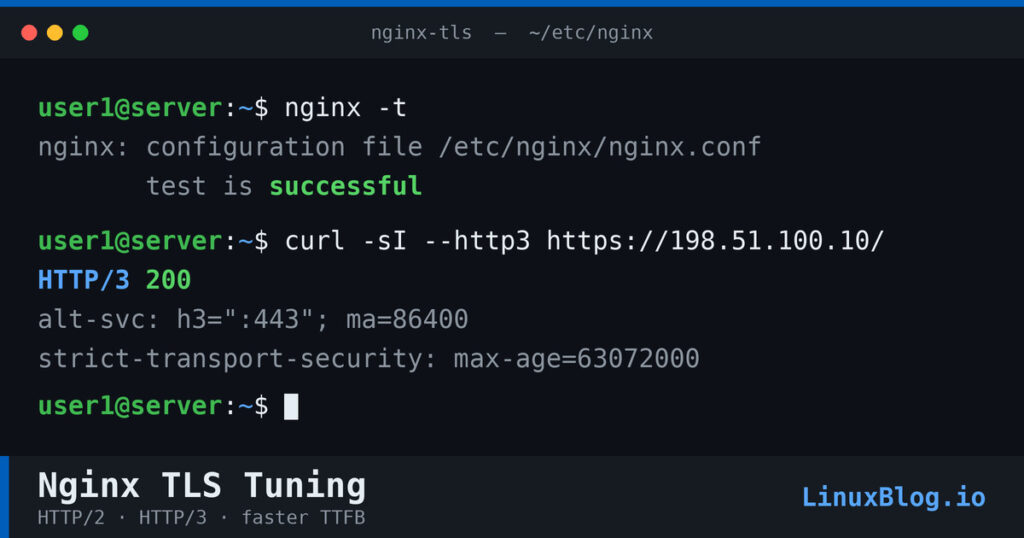
nginx -s reloadPer verificare rapidamente da riga di comando quale protocollo state effettivamente servendo:

curl --http2 -I https://vostrodominio.it/
curl --http3 -I https://vostrodominio.it/Session cache e session ticket: il vero risparmio sull’handshakeCon HTTPS, invece di una singola andata e ritorno, la connessione richiede un handshake aggiuntivo. Attivare la cache delle sessioni TLS riduce questo costo per le connessioni ripetute:

ssl_session_cache shared:SSL:10m; # circa 40.000 sessioni
ssl_session_timeout 1d; # tempo di riutilizzo della sessioneSui session ticket la raccomandazione è cambiata rispetto a qualche anno fa. Un tempo si consigliava di disabilitarli perché la rotazione della chiave di cifratura non era gestita correttamente da Nginx. Da Nginx 1.23.2 in poi la gestione delle chiavi per la ripresa stateless delle sessioni è molto migliorata, quindi salvo casi particolari conviene tenerli attivi:

ssl_session_tickets on;Unica eccezione: se gestite più server Nginx dietro un bilanciatore senza sincronizzare le chiavi dei ticket tra le istanze, la ripresa della sessione si rompe silenziosamente e perdete il beneficio. In quel caso, sincronizzate le chiavi o disabilitate i ticket su tutta la flotta in modo coerente.

Quali versioni TLS tenere attiveTLS 1.0 e 1.1 sono obsoleti, bloccati da ogni browser moderno e vietati dallo standard PCI DSS: vanno disattivati ovunque, senza eccezioni. La vera decisione riguarda invece TLS 1.2 e 1.3.

Per la maggior parte dei siti pubblici, la scelta corretta è tenere entrambi attivi:

ssl_protocols TLSv1.2 TLSv1.3;È TLS 1.3 a fare la differenza sul TTFB: riduce l’handshake a un singolo round trip e supporta la ripresa di sessione, quindi i visitatori che tornano si connettono più rapidamente. TLS 1.2 resta come fallback per client più datati e, su un sito pubblico normale, non costa nulla lasciarlo attivo.

Passate a TLS 1.3 soltanto se controllate i client che si connettono: un’API interna, un backend applicativo, un servizio dove sapete con certezza che nessun client datato deve collegarsi:

ssl_protocols TLSv1.3;Disabilitare TLS 1.2 su un sito pubblico è il tipo di modifica che sembra pulita in un file di configurazione e poi silenziosamente taglia fuori una fetta di traffico reale. Senza un motivo specifico, lasciatelo acceso.

OCSP stapling: cosa è cambiato con Let’s EncryptL’OCSP stapling permette a Nginx di allegare all’handshake una prova firmata dalla CA della validità del certificato, evitando che il client debba interrogare direttamente il servizio OCSP. La configurazione classica resta questa:

ssl_stapling on;
ssl_stapling_verify on;
ssl_trusted_certificate /path/to/full_chain.pem;
resolver 8.8.8.8 8.8.4.4 valid=300s;
resolver_timeout 5s;Ma qui c’è un cambiamento importante da conoscere se usate Let’s Encrypt: il 6 agosto 2025 Let’s Encrypt ha terminato il supporto OCSP e spento i propri responder. I certificati che emette oggi non hanno più un URL OCSP, ma un URL CRL al suo posto. Senza un responder da interrogare, ssl_stapling on; non fa più nulla sui certificati Let’s Encrypt e Nginx registra nei log un warning "ssl_stapling" ignored, no OCSP responder URL.

Il bilancio onesto nel 2026 è questo: se la vostra CA pubblica ancora un URL OCSP, lo stapling resta un piccolo vantaggio innocuo e potete tenerlo attivo. Se siete su Let’s Encrypt, le direttive sopra sono ormai inerti e potete rimuoverle per tenere puliti configurazione e log. È parte di uno spostamento più ampio del settore verso CRL e certificati a vita breve.

Buffer SSL più piccolo per ridurre il TTFBIl parametro ssl_buffer_size imposta la dimensione del buffer usato per inviare dati via HTTPS. Il valore predefinito è 16k, pensato per risposte di grandi dimensioni, ma per minimizzare il TTFB conviene spesso un valore più piccolo:

ssl_buffer_size 4k;Il risparmio tipico è di 30-50 millisecondi sul TTFB, variabile a seconda del carico e delle dimensioni medie delle risposte servite.

Configurazione completa consigliata per il 2026http2 on;
ssl_protocols TLSv1.2 TLSv1.3;
ssl_prefer_server_ciphers off;
ssl_ciphers 'ECDHE-ECDSA-AES128-GCM-SHA256:ECDHE-RSA-AES128-GCM-SHA256:ECDHE-ECDSA-AES256-GCM-SHA384:ECDHE-RSA-AES256-GCM-SHA384:ECDHE-ECDSA-CHACHA20-POLY1305:ECDHE-RSA-CHACHA20-POLY1305';
ssl_session_cache shared:SSL:10m;
ssl_session_timeout 1d;
ssl_session_tickets on;
ssl_buffer_size 4k;

add_header Strict-Transport-Security "max-age=63072000; includeSubdomains; preload";
add_header X-Frame-Options sameorigin;
add_header X-Content-Type-Options nosniff;Da notare: con TLS 1.3 le cipher suite sono fissate dal protocollo stesso, quindi una lunga stringa ssl_ciphers personalizzata e una direttiva ssl_ecdh_curve manuale non portano quasi nessun beneficio. I cipher elencati sopra si applicano soltanto alle connessioni TLS 1.2, e ssl_prefer_server_ciphers va disattivato perché i client moderni scelgono in modo sensato per conto proprio. Piuttosto che ottimizzare a mano all’infinito, generate una configurazione aggiornata con il Mozilla SSL Configuration Generator e incollate solo le parti che vi servono.

Se avete ancora in configurazione una riga X-Xss-Protection "1; mode=block", rimuovetela: l’XSS auditor del browser che controllava è stato eliminato da tutti i browser principali, e in alcuni casi quell’header può addirittura introdurre vulnerabilità invece di prevenirle. Una Content-Security-Policy è il sostituto moderno.

ConclusioneNessuna di queste modifiche, presa singolarmente, trasformerà le prestazioni del vostro sito. Ma insieme costituiscono un livello di ottimizzazione a costo pressoché nullo che qualsiasi sistemista dovrebbe verificare almeno una volta l’anno, specialmente dopo un major upgrade di Nginx o un rinnovo dell’infrastruttura dei certificati. Testate sempre con nginx -t prima di ricaricare, verificate il risultato con SSL Labs e con l’ispezione della colonna Protocol negli strumenti di sviluppo del browser, e ricordate che il vero collo di bottiglia, nella maggior parte dei casi, resta ciò che succede dopo l’handshake: cache, query e tempo di generazione della risposta.

Fonte: Nginx tuning tips: HTTPS/TLS – Turbocharge TTFB/Latency, LinuxBlog.io (Hayden James).

#sicurezza #linux #tutorial #performance #nginx #tlsssl

0

Caricamento...

0
1

Caricamento...

HollowByte: come 11 byte possono esaurire la memoria dei server OpenSSL

Ogni tanto una vulnerabilità ricorda quanto la nostra infrastruttura digitale dipenda da librerie fondamentali che diamo per scontate. È il caso di Ho

Altro...

Ogni tanto una vulnerabilità ricorda quanto la nostra infrastruttura digitale dipenda da librerie fondamentali che diamo per scontate. È il caso di HollowByte, una falla di tipo Denial of Service scoperta dal team di ricerca di Okta in OpenSSL: con un payload malevolo di appena 11 byte, un attaccante remoto e non autenticato può costringere un server ad allocare quantità di memoria completamente sproporzionate, prima ancora che l’handshake di sicurezza abbia inizio.

Per chi gestisce server web, database o qualsiasi servizio che parla TLS — quindi, in pratica, quasi tutti i sistemisti — vale la pena capire come funziona e, soprattutto, cosa fare subito.

Fidarsi ciecamente dell’headerL’handshake TLS comincia con un messaggio ClientHello incapsulato in un record. Ogni messaggio di handshake porta un header di 4 byte che dichiara quanto sarà grande il corpo del messaggio in arrivo.

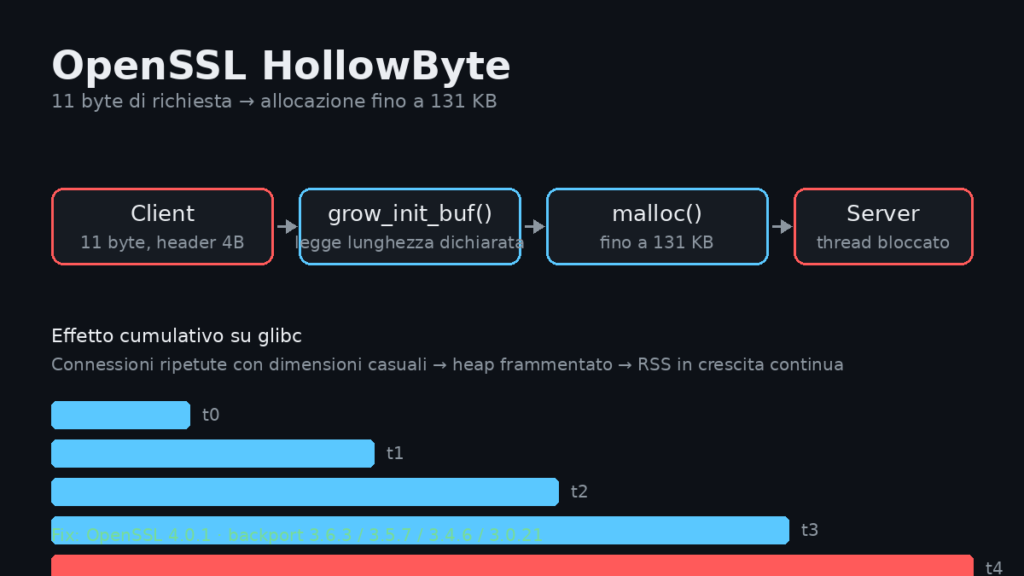
Nelle versioni vulnerabili di OpenSSL, il buffer di ricezione viene allocato sulla base di quella lunghezza dichiarata dall’attaccante, prima ancora che i dati siano effettivamente arrivati. La catena di chiamate è semplice quanto pericolosa:

Lettura header (4 byte)
→ grow_init_buf()
→ OPENSSL_clear_realloc()
→ malloc(dimensione_dichiarata_dall_attaccante)Poiché a questo stadio non esiste alcuna validazione del payload, un header che dichiara una lunghezza di 3 byte può far allocare fino a 131 KB basandosi solo sulla dichiarazione del pacchetto, che nessuno verifica. Il worker thread resta poi bloccato ad attendere dati che non arriveranno mai.

L’effetto moltiplicatore: la frammentazione della memoriaTenere connessioni aperte per esaurire i thread è un trucco vecchio quanto Slowloris. Quello che rende HollowByte più insidioso è l’interazione con la gestione della memoria di glibc (GNU C Library).

Quando una connessione dell’attaccante si chiude, OpenSSL libera il buffer — ma glibc non restituisce immediatamente al sistema operativo le allocazioni di dimensione piccola o media: le trattiene per un possibile riutilizzo. Lanciando ondate di connessioni con dimensioni dichiarate casuali, un attaccante impedisce all’allocatore di riutilizzare in modo efficiente quei blocchi liberati. L’heap si frammenta pesantemente e la Resident Set Size (RSS) del processo cresce in modo continuo.

Il punto critico è questo: anche dopo che l’attaccante si è disconnesso, il processo resta con un footprint di memoria permanentemente gonfiato. L’unico modo per recuperarla davvero è riavviare il servizio.

I numeri dei testIl team di Okta ha testato istanze OpenSSL patchate e non patchate dietro NGINX, sotto diverse condizioni di carico:

In un ambiente con 1 GB di RAM, il server non patchato è stato terminato dall’OOM killer dopo aver accumulato 547 MB di memoria frammentata e inutilizzabile

In un ambiente con 16 GB di RAM, l’attacco ha bloccato il 25% della memoria totale del sistema, restando sotto la soglia massima di connessioni consentite — il che significa che le classiche difese basate su rate limiting delle connessioni non fermano questo attacco

Dato che OpenSSL è incorporato ovunque, l’impatto potenziale copre web server (Apache, NGINX), runtime di linguaggi (Node.js, Python, Ruby, PHP) e database (MySQL, PostgreSQL) che si appoggiano alla libreria per TLS.

La correzione: crescita incrementale del bufferIl team OpenSSL ha risolto il problema passando a una crescita incrementale del buffer (merge delle pull request , e ): invece di fidarsi della lunghezza dichiarata nell’header, il buffer cresce solo quando i byte arrivano effettivamente sulla connessione. Una dichiarazione senza seguito ora non costa più nulla al server.

Il fix è stato incluso silenziosamente nella release OpenSSL 4.0.1, con backport altrettanto silenziosi sulle versioni:

3.6.3
3.5.7
3.4.6
3.0.21Un dettaglio non trascurabile: OpenSSL ha trattato la correzione come un semplice hardening fix, senza assegnare un CVE ufficiale, nonostante la gravità dell’impatto. Questo significa che molti scanner di vulnerabilità basati solo su database CVE potrebbero non segnalare l’esposizione: va verificata manualmente la versione installata.

Cosa fare subitoAlcune azioni concrete da mettere in pratica sui vostri sistemi:

Verificate la versione di OpenSSL su tutti i server esposti:

openssl version -aAggiornate i pacchetti di sistema alla versione patchata più recente disponibile per la vostra distribuzione:

Debian/Ubuntu

apt update && apt list --upgradable | grep -i openssl
apt install --only-upgrade openssl libssl3

RHEL/Fedora/Alma

dnf check-update openssl
dnf update opensslNon fermatevi al pacchetto di sistema: controllate anche runtime e linguaggi che incorporano una propria build di OpenSSL (build statiche di Node.js, alcune distribuzioni Python, container con immagini “slim” che a volte portano versioni di OpenSSL più vecchie di quelle dell’host)

Monitorate la RSS dei processi che terminano connessioni TLS, non solo il numero di connessioni attive: un aumento di memoria residente senza corrispondente crescita del traffico è un segnale d’allarme

Irrigidite i timeout di handshake lato reverse proxy, ad esempio su NGINX:

ssl_handshake_timeout 10s;
client_header_timeout 10s;Valutate regole di rate limiting sulle nuove connessioni TLS per IP a livello di firewall o WAF, anche se — come mostrato dai test — da sole non bastano contro questa specifica tecnica

ConclusioneHollowByte è un buon esempio di come un bug apparentemente piccolo — la fiducia cieca in un header di pochi byte — possa diventare un vettore di Denial of Service difficile da rilevare con le metriche di monitoraggio standard, perché resta sotto le soglie di allarme sulla banda e sulle connessioni. La buona notizia è che la correzione è già disponibile e il percorso di mitigazione è chiaro: aggiornare OpenSSL su tutta la superficie esposta, non fidarsi solo dei database CVE per capire se si è vulnerabili, e aggiungere il monitoraggio della memoria residente ai controlli già in essere sui vostri servizi TLS.

Fonte: BleepingComputer e Okta Security.

#sicurezza #linux #tlsssl #sysadmin #ddos #openssl #vulnerabilità

0

Caricamento...

0
1

Caricamento...